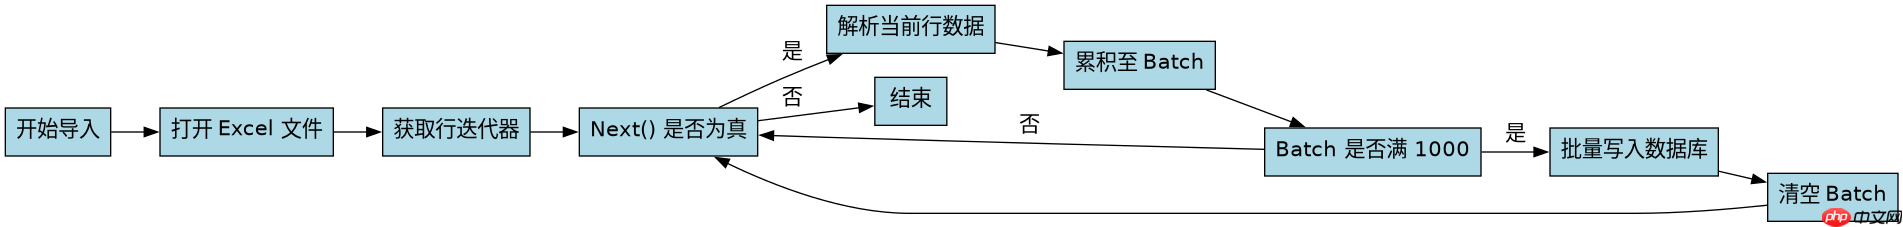
使用goframe框架导入海量excel数据,核心方案是放弃一次性加载到内存,改用流式读取配合数据库批量插入。具体做法是利用 gexcel 库的 readbystream 方法获取行迭代器,在遍历每一行时构建结构体切片,当累积到一定数量(如1000条)时调用 gorm 或原生sql进行批量写入并清空内存。这样做能确保在处理百万级数据时内存占用保持平稳,避免oom。
如何配置流式读取以支持大文件
配置流式读取的关键在于初始化 gexcel.Reader 时指定正确的解析器,并调用 ReadByStream 而非 Read。该接口返回一个包含所有行的迭代对象,开发者通过循环调用 Next() 逐行处理。这种方式下,Excel文件内容不会全部载入内存,而是按需从磁盘或IO流中读取,从而支撑GB级别的表格文件。

package main

import (
    "context"
    "fmt"
    "github.com/gogf/gf/v2/os/gfile"
    "github.com/gogf/gf/v2/text/gstr"
    "github.com/gogf/gf/v2/util/gconv"
    "github.com/xuri/excelize/v2"
)

type User struct {
    Name string
    Age  int
}

func main() {
    ctx := context.Background()
    file := gfile.RealPath("./data.xlsx")

    // 1. 创建 Excel 解析器
    reader, err := excelize.OpenFile(file)
    if err != nil {
        panic(err)
    }
    defer reader.Close()

    // 2. 获取 Sheet 名称
    sheetName := reader.GetSheetName(0)
    rows, err := reader.Rows(sheetName)
    if err != nil {
        panic(err)
    }

    // 3. 流式遍历
    batch := make([]User, 0, 1000)
    count := 0
    for rows.Next() {
        values, err := rows.Columns()
        if err != nil {
            fmt.Println("Error reading row:", err)
            continue
        }
        if len(values) == 0 { continue }

        // 跳过表头
        if count == 0 {
            count++
            continue
        }

        user := User{
            Name: values[0],
            Age:  gconv.Int(values[1]),
        }
        batch = append(batch, user)

        // 每1000条提交一次
        if len(batch) >= 1000 {
            saveToDB(ctx, batch)
            batch = make([]User, 0, 1000)
        }
        count++
    }

    // 处理剩余数据
    if len(batch) > 0 {
        saveToDB(ctx, batch)
    }
}

func saveToDB(ctx context.Context, users []User) {
    fmt.Printf("Saving %d records...\n", len(users))
    // 此处模拟数据库插入
}
如何处理数据清洗与类型转换
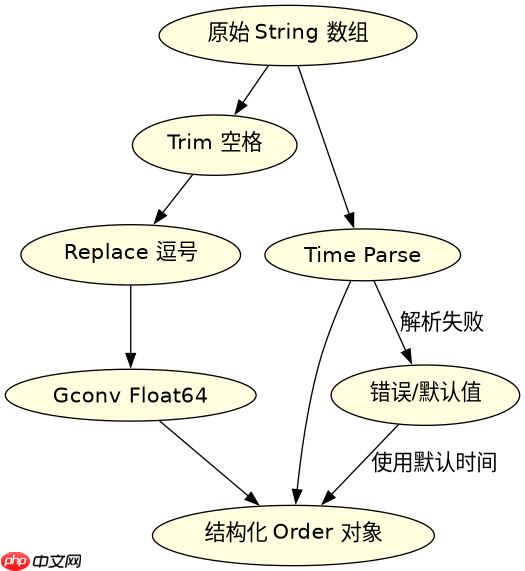
在流式读取过程中,原始单元格数据通常以字符串形式呈现,需要进行清洗和类型转换才能存入业务模型。利用 gconv 包可以安全地将字符串转换为整数、浮点数或布尔值,同时处理空值和异常格式。对于日期列,需根据Excel存储格式(如序列号或特定字符串)进行格式化转换,确保入库数据的一致性。
package main

import (
    "fmt"
    "time"
    "github.com/gogf/gf/v2/util/gconv"
)

type Order struct {
    ID       string
    Amount   float64
    CreateAt time.Time
}

func parseRow(values []string) (*Order, error) {
    if len(values) < 3 {
        return nil, fmt.Errorf("invalid row length")
    }

    // 清洗 ID:去除首尾空格
    id := gstr.Trim(values[0])
    if id == "" {
        return nil, fmt.Errorf("empty ID")
    }

    // 转换金额:支持千分位逗号
    amountStr := gstr.Replace(values[1], ",", "")
    amount := gconv.Float64(amountStr)

    // 转换时间:假设格式为 YYYY-MM-DD
    t, err := time.Parse("2006-01-02", values[2])
    if err != nil {
        // 尝试其他格式或记录错误
        t = time.Now()
    }

    return &Order{
        ID:       id,
        Amount:   amount,
        CreateAt: t,
    }, nil
}

func main() {
    sample := []string{" ORD-001 ", "1,234.56", "2023-10-01"}
    order, _ := parseRow(sample)
    fmt.Printf("Parsed: %+v\n", order)
}
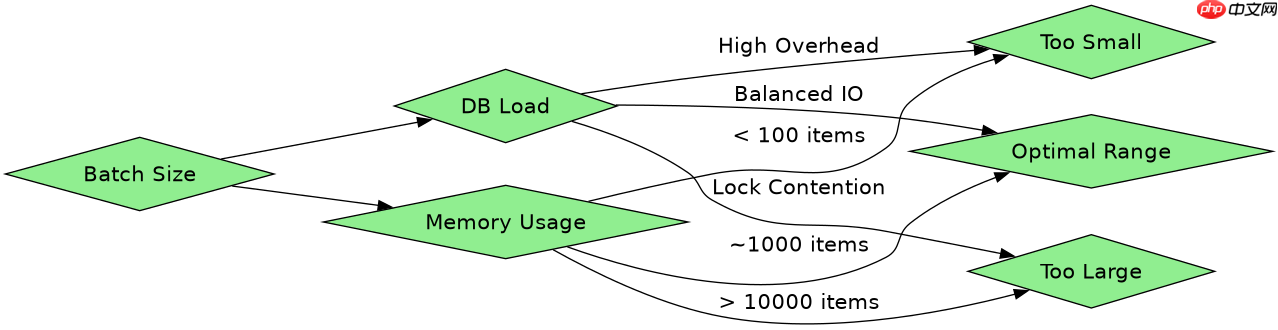
基于单批次1000条数据的内存控制问题
当设定单批次处理1000条数据时,内存峰值主要取决于这1000个结构体的大小以及Go运行时分配的额外开销。对于包含少量字段的简单结构体,1000条记录的内存占用通常在几百KB到几MB之间,这对现代服务器而言微不足道。关键在于及时将已处理的批次释放(置为nil或重新分配),防止切片无限增长导致内存泄漏。