








在go-zero框架中连接mongodb并处理海量数据,核心做法是初始化一个全局的mongo客户端实例,并在业务逻辑中通过该客户端获取集合(collection)进行操作。具体而言,需要在配置文件中定义mongodb的连接字符串、数据库名及认证信息,然后在代码中使用mongo.newclient创建连接对象,并通过connect方法建立会话。对于海量数据存储,建议结合分片策略或时间序列集合来优化写入性能,同时利用索引加速查询。
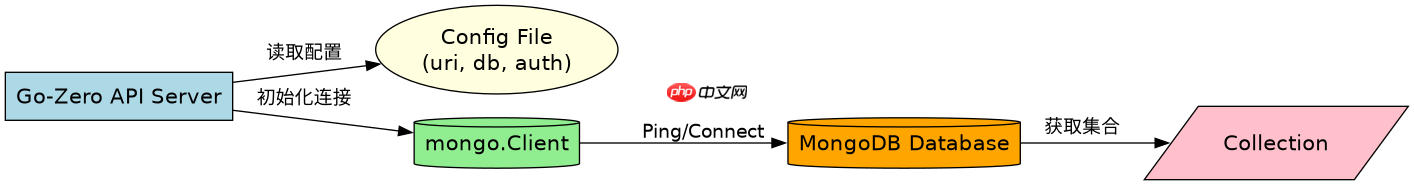
MongoDB连接配置与初始化流程是怎样的
连接MongoDB的第一步是在etc目录下的配置文件(如api.yaml或core.yaml)中声明连接参数。Go-Zero通常使用go.mongodb.org/mongo-driver作为底层驱动。开发者需要编写一个初始化函数,读取配置中的Uri和Database字段,设置超时时间和重试策略,最终返回一个可用的*mongo.Client实例。这一步确保了应用启动时就能验证数据库连通性,避免运行时出现连接错误。
package main

import (
    "context"
    "fmt"
    "log"
    "time"

    "go.mongodb.org/mongo-driver/bson"
    "go.mongodb.org/mongo-driver/mongo"
    "go.mongodb.org/mongo-driver/mongo/options"
)

// 模拟配置结构
type Config struct {
    Uri      string
    Database string
}

var client *mongo.Client

func InitMongo(cfg Config) error {
    ctx, cancel := context.WithTimeout(context.Background(), 10*time.Second)
    defer cancel()

    opts := options.Client().ApplyURI(cfg.Uri).SetMaxPoolSize(100)
    var err error
    client, err = mongo.Connect(ctx, opts)
    if err != nil {
        return fmt.Errorf("connect mongo failed: %w", err)
    }

    if err = client.Ping(ctx, nil); err != nil {
        return fmt.Errorf("ping mongo failed: %w", err)
    }

    log.Println("Successfully connected to MongoDB")
    return nil
}

func GetCollection(dbName, collName string) *mongo.Collection {
    return client.Database(dbName).Collection(collName)
}

func main() {
    cfg := Config{
        Uri:      "mongodb://localhost:27017",
        Database: "huge_data_db",
    }
    if err := InitMongo(cfg); err != nil {
        log.Fatal(err)
    }

    coll := GetCollection("huge_data_db", "logs")
    doc := bson.M{"timestamp": time.Now(), "level": "info"}
    _, err := coll.InsertOne(context.Background(), doc)
    if err != nil {
        log.Fatal(err)
    }
    fmt.Println("Data inserted successfully")
}
上述代码展示了完整的初始化过程。首先定义Config结构体映射配置项。在InitMongo函数中,使用options.Client()配置连接参数,特别是SetMaxPoolSize对于高并发场景至关重要。接着调用mongo.Connect建立连接,并通过Ping方法验证连通性。最后提供GetCollection辅助函数,方便业务层直接获取集合对象进行CRUD操作。

海量数据写入时如何优化性能与可靠性
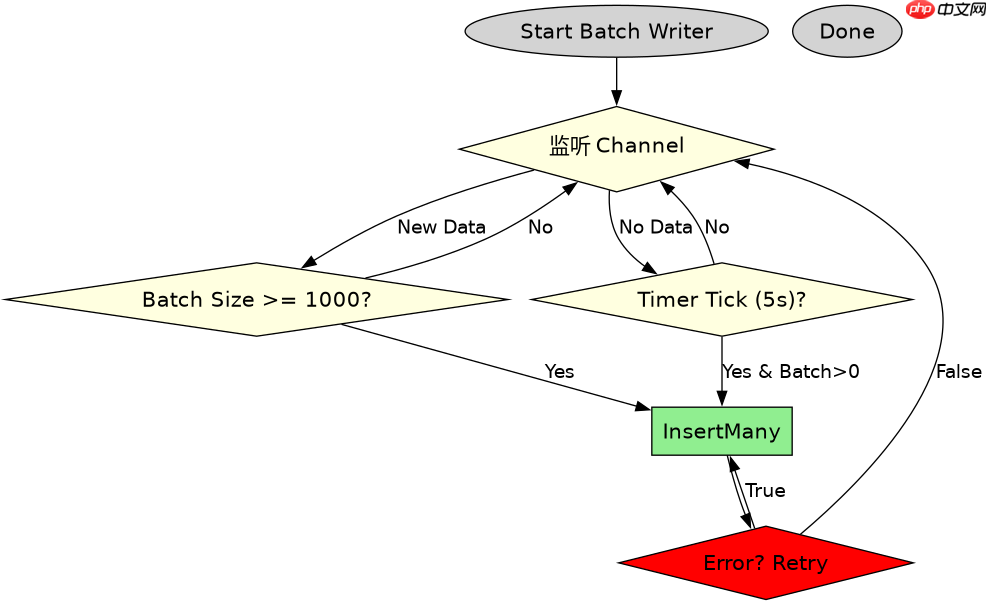
面对海量数据,单次插入效率低下且容易阻塞主线程。最佳实践是使用InsertMany进行批量写入,或者使用BulkWrite执行混合操作。为了进一步提升吞吐量,可以开启写确认机制(Write Concern)的权衡,或在应用层实现异步队列缓冲。此外,合理设计文档结构,避免过大的BSON对象,也是提升写入速度的关键。在Go-Zero的服务架构中,可以将数据写入逻辑封装在独立的Worker中,通过Channel接收上游数据,实现削峰填谷。

package main

import (
    "context"
    "fmt"
    "log"
    "sync"
    "time"

    "go.mongodb.org/mongo-driver/bson"
    "go.mongodb.org/mongo-driver/mongo"
    "go.mongodb.org/mongo-driver/mongo/options"
)

var (
    client *mongo.Client
    wg     sync.WaitGroup
)

const batchSize = 1000

func StartBatchWriter(coll *mongo.Collection, dataChan <-chan bson.M) {
    go func() {
        batch := make([]bson.M, 0, batchSize)
        ticker := time.NewTicker(5 * time.Second)
        defer ticker.Stop()

        for {
            select {
            case doc, ok := <-dataChan:
                if !ok {
                    // Channel关闭,发送剩余批次
                    if len(batch) > 0 {
                        writeBatch(coll, batch)
                    }
                    wg.Done()
                    return
                }
                batch = append(batch, doc)
                if len(batch) >= batchSize {
                    writeBatch(coll, batch)
                    batch = make([]bson.M, 0, batchSize)
                }
            case <-ticker.C:
                if len(batch) > 0 {
                    writeBatch(coll, batch)
                    batch = make([]bson.M, 0, batchSize)
                }
            }
        }
    }()
}

func writeBatch(coll *mongo.Collection, docs []bson.M) {
    if len(docs) == 0 {
        return
    }

    // 设置WriteConcern为Majority以确保数据持久化,可根据需求调整
    opts := options.InsertMany().SetOrdered(false)
    _, err := coll.InsertMany(context.Background(), docs, opts)
    if err != nil {
        log.Printf("batch insert failed: %v, retrying...", err)
        // 简单重试逻辑
        time.Sleep(1 * time.Second)
        writeBatch(coll, docs)
    }
}

func main() {
    // 假设已初始化client
    coll := client.Database("huge_data_db").Collection("metrics")

    dataChan := make(chan bson.M, 5000)
    wg.Add(1)
    StartBatchWriter(coll, dataChan)

    // 模拟生成大量数据
    for i := 0; i < 10000; i++ {
        dataChan <- bson.M{
            "id":        i,
            "value":     float64(i),
            "timestamp": time.Now(),
        }
    }
    close(dataChan)
    wg.Wait()
    fmt.Println("All data processed")
}
这段代码演示了基于Channel的批量写入模式。StartBatchWriter启动一个协程,监听dataChan。当累积达到batchSize(例如1000条)或超过5秒定时器触发时,调用writeBatch执行InsertMany。这种模式有效减少了网络往返次数,提升了写入吞吐。同时,SetOrdered(false)允许部分失败继续执行,提高可靠性。在实际海量存储场景中,还可结合MongoDB的分片集群(Sharded Cluster)将数据分散到多个节点,进一步扩展存储容量和写入能力。
如何根据时间范围高效查询海量日志数据
在海量数据场景下,全表扫描是性能杀手。针对日志类数据,最常见的查询是按时间范围过滤。解决此问题的关键在于为时间字段建立复合索引。例如,若经常查询特定时间段内的日志,应创建包含timestamp和level的索引。在Go代码中,使用bson.M{"timestamp": bson.M{"$gte": startTime, "$lte": endTime}}`作为查询条件,配合<code>Find方法即可快速定位数据。此外,对于极大规模的历史数据归档,可考虑使用TTL索引自动删除过期文档,减少存储压力。


















