








xorm框架调用存储过程的核心方式是使用 exec 方法执行原生 sql 语句,因为存储过程通常包含复杂的逻辑和输出参数,无法直接映射到结构体。通过构建 call procedure_name(...) 格式的字符串并传入参数,可以完成调用。若涉及输出参数,需使用 mysql 用户变量(如 @var)进行中转,并在调用后再次查询获取结果。

如何调用无返回值的存储过程
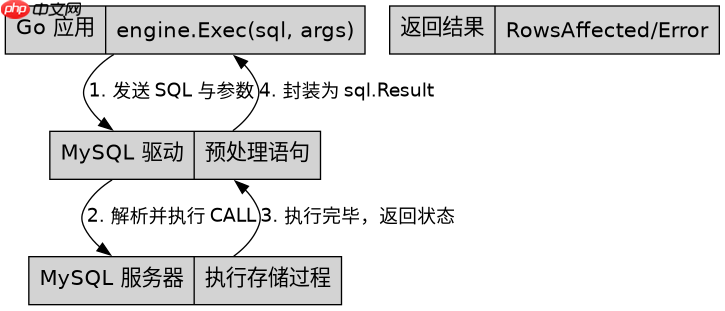
对于没有返回值或仅影响数据库状态的存储过程,直接使用 engine.Exec() 即可。该方法接受 SQL 字符串和可变参数,底层驱动会处理参数的绑定。这种方式简单直接,适用于删除、更新等纯副作用操作。
package main

import (
    "fmt"
    _ "github.com/go-sql-driver/mysql"
    "xorm.io/xorm"
)

func main() {
    engine, err := xorm.NewEngine("mysql", "user:password@tcp(127.0.0.1:3306)/dbname")
    if err != nil {
        panic(err)
    }
    defer engine.Close()

    // 假设存储过程名为 sp_delete_user,接受一个用户ID
    // CALL sp_delete_user(?)
    result, err := engine.Exec("CALL sp_delete_user(?)", 1001)
    if err != nil {
        fmt.Println("Error:", err)
        return
    }

    affected, _ := result.RowsAffected()
    fmt.Printf("Deleted %d rows\n", affected)
}
上述代码中,engine.Exec 接收两个参数:SQL 模板和具体的 ID 值。驱动会自动将 ? 替换为占位符并绑定参数。如果存储过程定义成功,result.RowsAffected() 将返回受影响的行数。若存储过程内部发生错误,err 将不为空。
如何获取存储过程的输出参数
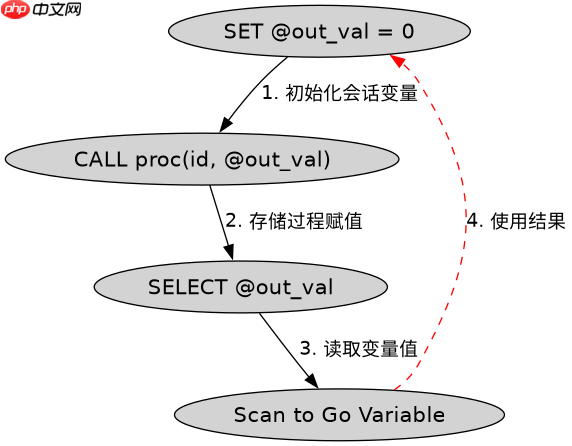
当存储过程需要返回数据时,MySQL 不支持直接作为函数返回值,必须借助用户变量。在调用前声明变量,在存储过程中赋值给该变量,调用后再通过 SELECT @var 查询出来。这是 XORM 处理输出参数的标准模式。
package main

import (
    "fmt"
    "xorm.io/xorm"
)

func main() {
    engine, _ := xorm.NewEngine("mysql", "user:password@tcp(127.0.0.1:3306)/dbname")
    defer engine.Close()

    var outputVal int

    // 第一步:初始化用户变量
    engine.Exec("SET @out_result = 0")

    // 第二步:调用存储过程,将输出赋给用户变量
    // 假设存储过程定义为: CREATE PROCEDURE sp_get_count(IN uid INT, OUT cnt INT)
    engine.Exec("CALL sp_get_count(?, @out_result)", 1001)

    // 第三步:查询用户变量的值
    err := engine.QueryRow("SELECT @out_result").Scan(&outputVal)
    if err != nil {
        fmt.Println("Query Error:", err)
        return
    }

    fmt.Printf("Output Value: %d\n", outputVal)
}
在这个流程中,SET @out_result = 0 确保变量存在且初始化为零。接着 CALL sp_get_count(?, @out_result) 执行存储过程,第二个参数是用户变量名而非普通占位符。最后 SELECT @out_result 将该变量值扫描到 Go 变量 outputVal 中。注意,用户变量名必须以 @ 开头,且在 SQL 字符串中直接书写,不要加引号。
如何处理存储过程中的多结果集
某些存储过程可能返回多个结果集,例如先返回状态码,再返回数据列表。XORM 的 Query 方法支持获取多结果集。通过 Rows.NextResultSet() 可以遍历后续的结果集。这对于需要同时获取元数据和详细数据的场景非常有用。
package main

import (
    "database/sql"
    "fmt"
    "xorm.io/xorm"
)

func main() {
    engine, _ := xorm.NewEngine("mysql", "user:password@tcp(127.0.0.1:3306)/dbname")
    defer engine.Close()

    // 假设存储过程返回两列:status (INT) 和 data (JSON)
    rows, err := engine.Query("CALL sp_complex_report()")
    if err != nil {
        panic(err)
    }
    defer rows.Close()

    // 读取第一个结果集:状态信息
    for rows.Next() {
        var status int
        var data string
        rows.Scan(&status, &data)
        fmt.Printf("Status: %d, Data: %s\n", status, data)
    }

    // 检查是否有下一个结果集
    if rows.NextResultSet() {
        // 读取第二个结果集:详细列表
        for rows.Next() {
            var id int
            var name string
            rows.Scan(&id, &name)
            fmt.Printf("Item ID: %d, Name: %s\n", id, name)
        }
    }
}
此代码展示了如何处理复杂存储过程。首先调用 engine.Query 获取 *sql.Rows 对象。通过循环 rows.Next() 处理第一组数据。调用 rows.NextResultSet() 切换到下一组数据,如果返回 true,则继续循环读取。这种方法避免了多次网络往返,提高了效率。需要注意的是,如果存储过程抛出异常,Query 会直接返回错误,不会进入循环。
























