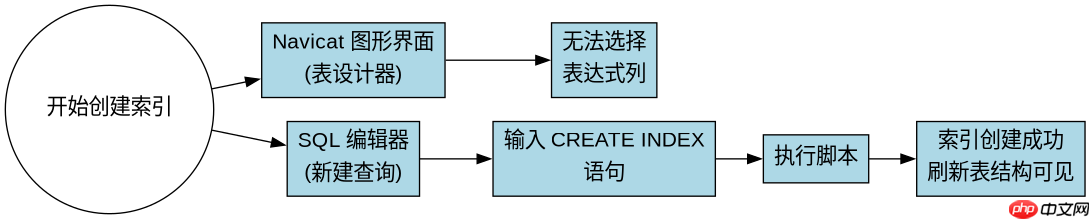
在navicat中为postgresql创建表达式索引,核心方法是使用sql编辑器执行包含函数或表达式的create index语句。由于navicat的图形化界面通常不支持直接选择表达式作为索引列,你需要手动编写如create index idx_name on table (upper(column)); 这样的命令并运行,从而实现对计算结果的快速检索。
Navicat图形界面为何无法直接创建表达式索引
Navicat的表设计器主要面向标准B-Tree索引,其界面逻辑是将物理列与索引关联。当用户尝试在“索引”选项卡中添加新项时,下拉菜单仅列出表中存在的实际字段名,而不提供输入任意SQL表达式的入口。这种限制源于GUI工具对复杂语法的抽象简化,导致涉及UPPER、LOWER或自定义函数的场景无法通过点击完成。

Navicat Premium 17.1 Windows x64 历史系列获取入口。该系列扩展 Garnet、PolarDB 等连接支持,并增强可视化查询解释与 Redis 树视图;未核实到公开固定安装包直链。
如何通过SQL编辑器实现表达式索引
绕过图形界面的唯一途径是直接使用SQL窗口。打开目标数据库连接,新建查询文件,输入标准的PostgreSQL索引创建语法。关键在于ON子句后必须紧跟括号内的表达式而非列名。例如,若需对email字段忽略大小写进行唯一约束或加速查询,应编写CREATE UNIQUE INDEX idx_email_upper ON users (UPPER(email));。执行该脚本后,PostgreSQL引擎会计算每行数据的表达式值并构建索引树。验证方式是在Navicat中刷新表结构,或在索引列表中查看新创建的条目,其名称即为脚本中定义的idx_email_upper。
表达式索引在实际查询中的匹配条件
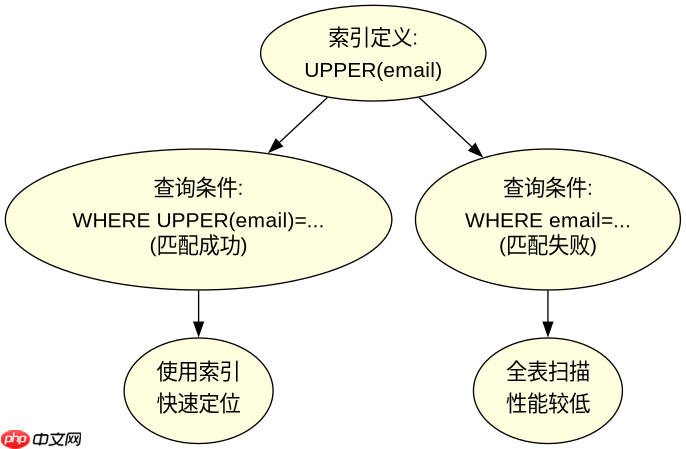
创建表达式索引后,只有当WHERE子句中的过滤条件与索引定义完全一致时,优化器才会使用该索引。这意味着如果索引定义为UPPER(name),查询时必须显式使用UPPER(name) = 'VALUE'。若查询语句写成name = 'value',即使数据相同,PostgreSQL也会回退到全表扫描,因为两者在语法树上不匹配。此外,表达式索引不存储原始数据,只存储计算结果,因此它不能替代普通索引用于排序或范围查询,除非表达式本身支持这些操作且查询条件与之对应。