








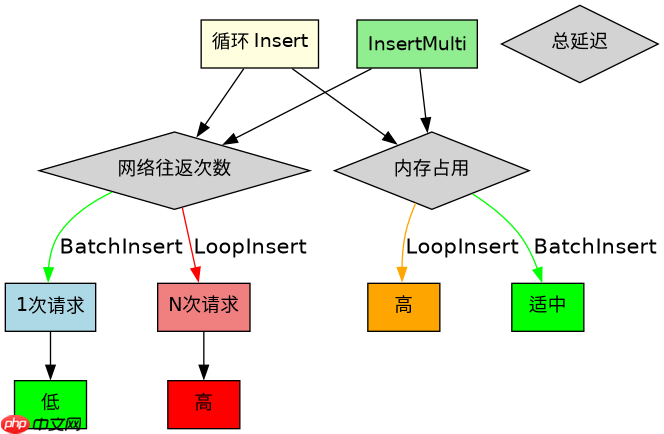
xorm框架进行批量数据插入推荐使用 insertmulti 方法,通过传入切片和单条记录对象来高效执行多条数据的写入。调用时需确保传入的切片非空且包含至少一条记录以触发批量逻辑,否则可能退化为普通插入或返回错误。该方法底层利用数据库驱动支持的批量语法(如 mysql 的 insert ... values (...), (...)),能显著减少网络往返次数并提升吞吐量。

InsertMulti 与循环 Insert 的性能差异体现在哪里
使用 InsertMulti 相比在 Go 代码中循环调用 Insert,主要优势在于将多次 SQL 执行合并为一次网络请求。循环插入会导致 N 次独立的数据库交互,而批量插入仅一次。对于大量数据,批量方式能极大降低延迟开销。
package main

import (
	"fmt"
	"log"
	"time"

	"xorm.io/xorm"
	_ "github.com/go-sql-driver/mysql"
)

type User struct {
	ID   int64  `xorm:"autoincr pk"`
	Name string `xorm:"varchar(100) notnull"`
	Age  int    `xorm:"int"`
}

func main() {
	// 初始化引擎,实际使用时请替换为正确的 DSN
	engine, err := xorm.NewEngine("mysql", "user:password@tcp(127.0.0.1:3306)/dbname")
	if err != nil {
		log.Fatal(err)
	}
	defer engine.Close()

	// 同步表结构
	if err := engine.Sync2(new(User)); err != nil {
		log.Fatal(err)
	}

	// 准备批量数据
	users := make([]User, 100)
	for i := 0; i < 100; i++ {
		users[i] = User{Name: fmt.Sprintf("user_%d", i), Age: 20 + i}
	}

	// 执行批量插入
	affected, err := engine.InsertMulti(users)
	if err != nil {
		log.Fatal(err)
	}

	fmt.Printf("Inserted %d records\n", affected)
}
上述代码中,InsertMulti 接收一个 []User 切片。若切片长度为 0,XORM 通常会直接返回 0 和 nil 错误,或者根据具体版本行为略有不同,但最佳实践是避免传入空切片。预期输出为 Inserted 100 records,表示成功插入了 100 条记录。
批量插入时如何处理主键冲突或唯一索引约束
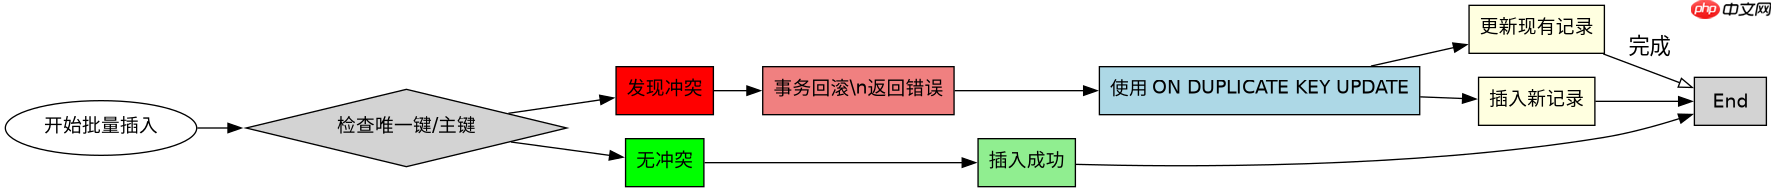
当批量插入的数据违反唯一索引约束(如主键重复)时,默认情况下数据库会抛出错误并回滚整个事务,导致所有数据插入失败。XORM 本身不自动处理冲突,需依赖数据库特性如 ON DUPLICATE KEY UPDATE (MySQL) 或 INSERT OR IGNORE (SQLite)。
package main

import (
	"fmt"
	"log"

	"xorm.io/xorm"
	_ "github.com/go-sql-driver/mysql"
)

type Product struct {
	ID      int64  `xorm:"autoincr pk"`
	Code    string `xorm:"unique varchar(50) notnull"`
	Name    string `xorm:"varchar(100)"`
	Stock   int    `xorm:"int default 0"`
}

func main() {
	engine, err := xorm.NewEngine("mysql", "user:password@tcp(127.0.0.1:3306)/test_db")
	if err != nil {
		log.Fatal(err)
	}
	defer engine.Close()

	// 假设表中已存在 Code="P001" 的记录
	products := []Product{
		{Code: "P001", Name: "Product A", Stock: 10}, // 冲突
		{Code: "P002", Name: "Product B", Stock: 20}, // 新插入
	}

	// 使用原生 SQL 实现 ON DUPLICATE KEY UPDATE
	// XORM 的 InsertMulti 不支持直接映射到 ON DUPLICATE KEY UPDATE
	// 因此需要构造自定义 SQL 或使用 Tx 配合 Upsert 逻辑
	// 这里演示一种常见的替代方案:先查后更,或使用 Raw SQL

	// 简单示例:如果必须用 InsertMulti 且容忍错误,则无法静默处理冲突
	// 正确做法是使用事务和条件判断,或编写特定 SQL

	// 下面展示如何使用 XORM 的 Exec 执行批量 Upsert 风格的 SQL (MySQL)
	// 注意:这并非 InsertMulti 的直接用法,而是解决冲突的策略

	// 为了演示 InsertMulti 的行为,我们看正常情况
	// 如果 P001 已存在,InsertMulti 会报错
	affected, err := engine.InsertMulti(products)
	if err != nil {
		fmt.Println("Error occurred due to conflict:", err)
	} else {
		fmt.Println("Affected rows:", affected)
	}
}
在 MySQL 中,若希望忽略冲突或更新现有记录,应使用 INSERT INTO ... ON DUPLICATE KEY UPDATE。XORM 的 InsertMulti 生成的是标准 INSERT 语句,遇到唯一键冲突时会立即终止并返回错误。开发者需在应用层捕获该错误,或改用 Exec 执行自定义 SQL 来实现幂等插入。例如,可以构建一个包含多个 VALUES 子句并附带 ON DUPLICATE KEY UPDATE 的 SQL 字符串,通过 engine.Exec(sql, args...) 执行,从而在批量操作中实现“存在则更新,不存在则插入”的逻辑。
批量插入超过一定数量时内存占用和性能瓶颈如何优化
当批量插入数据量极大(如数万条以上)时,将所有数据加载到内存切片中再一次性发送,可能导致内存峰值过高及 SQL 语句过长被数据库拒绝。优化策略是将大数据集分片(Chunking),每次插入固定数量的记录(如 500-1000 条),并在每批之间适当控制并发或休眠。
具体做法是将原始数据切片按固定大小分割,循环调用 InsertMulti。这样既保持了批量插入的高效性,又控制了单次请求的大小和内存占用。同时,确保数据库配置允许较大的 max_allowed_packet(MySQL)以避免 SQL 截断。通过分片,可以将内存复杂度从 O(N) 降低为 O(K),其中 K 为分片大小,显著提升系统稳定性。

















