








xorm框架批量更新的高效做法是调用 table 指定表名,使用 cols 明确要更新的字段,配合 where 限定范围,并传入包含主键的模型切片进行 update。这种方式会生成单条 sql 语句,通过 where id in (...) and ... 条件一次性完成修改,避免了在循环中逐条执行数据库操作带来的性能损耗。
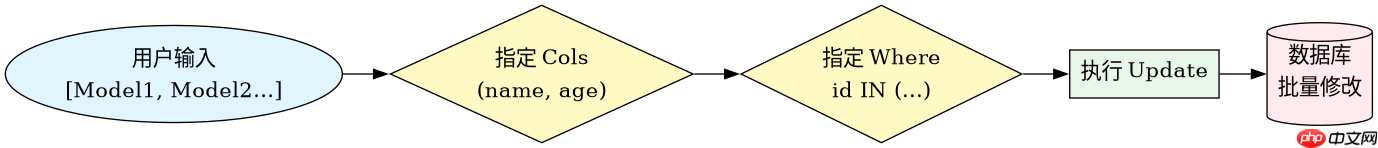
如何指定特定字段进行批量更新
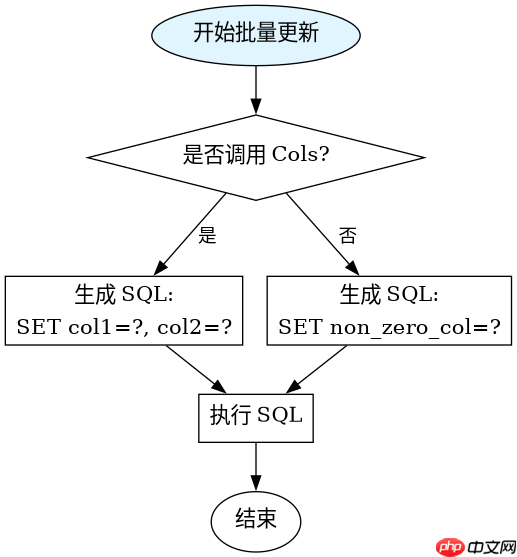
在使用 Update 时,必须显式调用 Cols 方法列出需要更新的列名。如果不加 Cols,XORM 默认只更新非零值字段,这会导致原本为 0 或空字符串的字段被跳过,从而产生数据不一致的问题。
package main

import (
	"fmt"
	"github.com/xorm.io/xorm"
	_ "github.com/go-sql-driver/mysql"
)

type User struct {
	ID   int64  `xorm:"pk autoincr"`
	Name string `xorm:"varchar(50)"`
	Age  int    `xorm:"int"`
}

func main() {
	env, _ := xorm.NewEngine("mysql", "user:pass@tcp(127.0.0.1:3306)/db")

	// 准备待更新的数据
	users := []User{
		{ID: 1, Name: "Alice", Age: 25},
		{ID: 2, Name: "Bob", Age: 30},
	}

	// 核心逻辑:指定表、指定列、设置条件、执行更新
	_, err := env.Table("users").Cols("name", "age").Where("id in (1, 2)").Update(&users)
	if err != nil {
		fmt.Println("Error:", err)
	}
}
上述代码生成的 SQL 类似于 UPDATE users SET name=?, age=? WHERE id IN (?, ?)。这种写法确保了只有 name 和 age 两个字段会被覆盖,其他字段保持原样。
如何处理大批量数据的分批更新
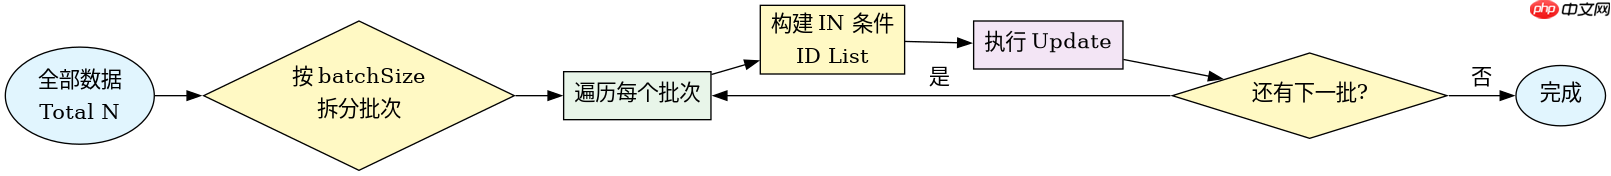
当需要更新的记录数量非常大(例如超过几千条)时,直接将所有 ID 放入 IN 子句可能会导致 SQL 语句过长或超出数据库限制。此时应将数据切分为较小的批次,循环执行更新操作。
func batchUpdate(env *xorm.Engine, users []User) error {
	batchSize := 100 // 每批处理100条
	for i := 0; i < len(users); i += batchSize {
		end := i + batchSize
		if end > len(users) {
			end = len(users)
		}
		batch := users[i:end]

		// 提取当前批次的ID用于构建Where条件
		ids := make([]int64, len(batch))
		for j, u := range batch {
			ids[j] = u.ID
		}

		_, err := env.Table("users").Cols("name", "age").Where("id in (?)", ids).Update(&batch)
		if err != nil {
			return err
		}
	}
	return nil
}
通过控制 batchSize,可以有效防止单次请求过大导致的内存溢出或数据库连接超时。每次循环都会生成一条独立的 UPDATE 语句,确保事务的稳定性和可控性。
批量更新时主键缺失会导致什么结果
如果传入 Update 的切片中某个对象缺少主键值,XORM 会将其视为全表更新操作。这意味着该次调用会清空所有符合条件(若未指定 Where)的记录,或者更新整张表,造成严重的数据灾难。
因此,在执行批量更新前,务必确保每个模型实例都携带了正确的 ID 或其他唯一标识符。在上面的示例中,users 切片里的每个元素都必须有有效的 ID,否则 Where("id in (...)") 将无法正确过滤,进而引发不可预期的后果。
























