








利用自连接(self-join)配合时间范围重叠判定条件,可以找出表中相互重叠的有效时间段。核心做法是将表与自身进行内连接,连接条件为前一条记录的结束时间大于后一条记录的开始时间,且前一条记录的id小于后一条记录的id以避免重复和自匹配,同时确保两条记录属于同一业务实体。
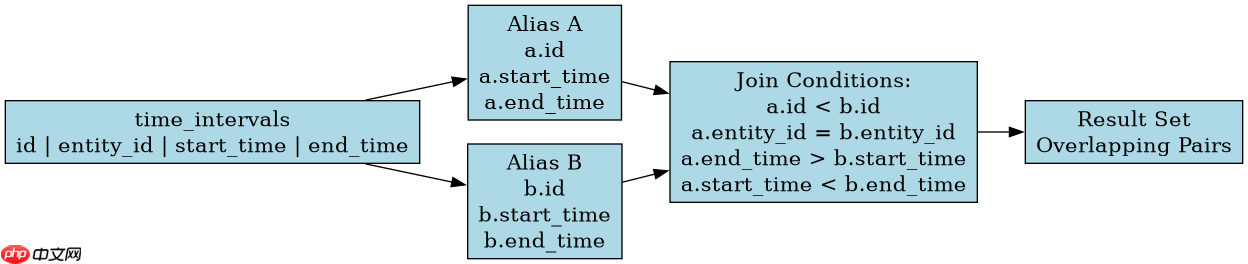
如何编写基础的重叠查询语句
基础查询通过比较两个别名表的起止时间戳来实现。假设表名为 time_intervals,包含 id、start_time 和 end_time 字段。查询时,将表分别别名为 a 和 b,连接条件为 a.id 保证顺序且不自我比较,以及 <code>a.end_time > b.start_time 判断时间是否有交集。如果还需要考虑边界情况(如端点接触是否算重叠),可调整比较运算符为 >=。
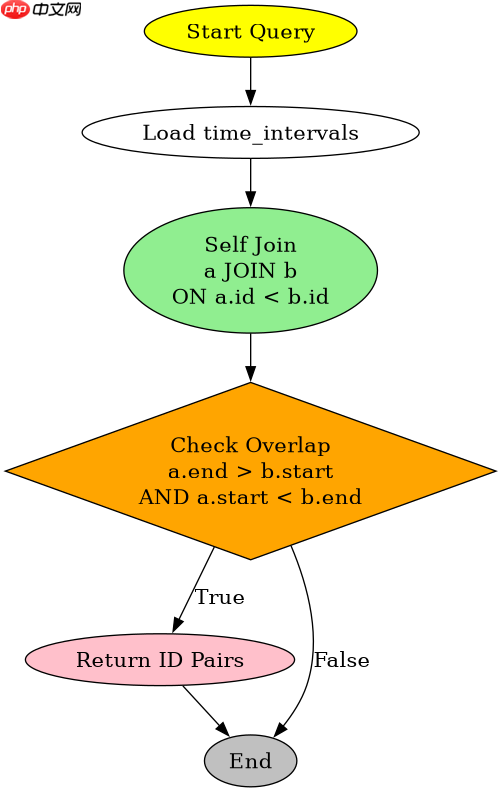
SELECT a.id AS id1, b.id AS id2, a.start_time, a.end_time, b.start_time, b.end_time
FROM time_intervals a
JOIN time_intervals b ON a.id < b.id
    AND a.end_time > b.start_time
    AND a.start_time < b.end_time;
上述代码中,第三个条件 a.start_time 是必要的,因为仅凭 <code>a.end_time > b.start_time 只能说明 a 的开始时间在 b 的结束时间之前,不能保证 b 的开始时间在 a 的结束时间之前。只有当两个区间互相“侵入”对方时,才构成真正的重叠。执行该查询将返回所有重叠对的 ID 组合及各自的时间段。
如何处理同一实体的多组重叠数据
在实际业务中,时间段通常归属于某个实体(如用户ID或设备ID)。为了查找特定实体下的重叠时间段,需要在连接条件中加入实体标识符的相等判断。例如,若表中有 entity_id 字段,则连接条件需增加 a.entity_id = b.entity_id。这样可以隔离不同实体之间的数据,避免跨实体的误判。
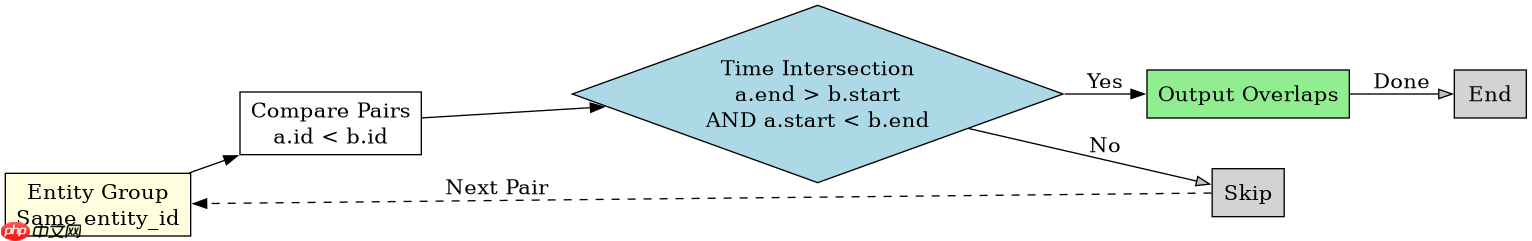
SELECT a.id AS id1, b.id AS id2, a.entity_id
FROM time_intervals a
JOIN time_intervals b ON a.entity_id = b.entity_id
    AND a.id < b.id
    AND a.end_time > b.start_time
    AND a.start_time < b.end_time;
此查询确保了只比较同一 entity_id 下的记录。如果存在多个重叠组,结果集会列出每一对重叠的记录。对于需要合并重叠区间的场景,此查询可作为第一步,识别出哪些记录需要被聚合处理。
基于输入条件判断端点接触是否视为重叠
当输入数据中存在相邻时间段,即一个区间的结束时间等于另一个区间的开始时间时,是否视为重叠取决于业务定义。在标准数学区间定义中,[1,2] 和 [2,3] 仅在点 2 处接触,通常不视为内部重叠。在上述查询中,使用严格大于号 > 和严格小于号 排除了端点接触的情况。若业务要求将端点接触也视为重叠(例如资源占用不允许瞬间切换),应将条件修改为 <code>>= 和 。例如,将 <code>a.end_time > b.start_time 改为 a.end_time >= b.start_time,这样 [1,2] 和 [2,3] 将被判定为重叠。

















