








在sql server中正确使用approx_count_distinct进行预估,核心在于理解它返回的是近似值而非精确值,适用于对性能要求高于绝对精度的大数据量统计场景。调用时只需将标准count(distinct)替换为approx_count_distinct(column_name)即可,它会基于hyperloglog算法给出一个误差率通常在2%以内的估算结果。需要注意的是,该函数不支持distinct关键字嵌套(即不能写approx_count_distinct(distinct ...)),且无法处理null值以外的复杂聚合逻辑,若需精确计数仍应使用传统方法。
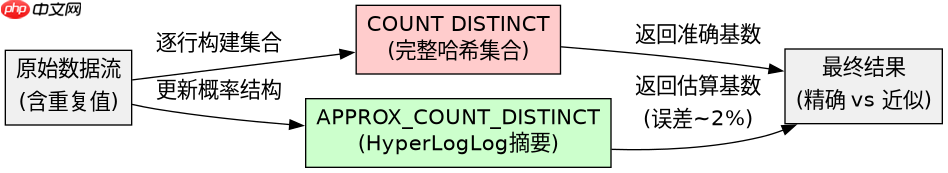
APPROX_COUNT_DISTINCT与COUNT DISTINCT的性能差异体现在哪里
两者在处理大规模数据时的资源消耗截然不同,APPROX_COUNT_DISTINCT通过概率数据结构大幅降低了内存和CPU开销。COUNT DISTINCT需要维护一个完整的去重集合,当基数极大时会导致严重的排序和哈希冲突,而APPROX版本仅维护固定大小的摘要信息。这种差异使得近似函数在亿级行数扫描中仍能保持毫秒级响应,尽管牺牲了少量精度。
-- 创建测试表并插入大量重复数据
CREATE TABLE SalesData (
    SaleID INT IDENTITY(1,1),
    CustomerID INT,
    Amount DECIMAL(10,2)
);

-- 模拟100万条数据,CustomerID有10万个唯一值
INSERT INTO SalesData (CustomerID, Amount)
SELECT TOP 1000000
    ABS(CHECKSUM(NEWID())) % 100000 + 1,
    RAND(CHECKSUM(NEWID())) * 100
FROM sys.objects a CROSS JOIN sys.objects b;

-- 对比两种查询的执行时间和结果
SET STATISTICS TIME ON;

-- 精确计数:耗时较长,内存占用高
SELECT COUNT(DISTINCT CustomerID) AS ExactCount FROM SalesData;

-- 近似计数:耗时极短,内存占用低
SELECT APPROX_COUNT_DISTINCT(CustomerID) AS ApproxCount FROM SalesData;

SET STATISTICS TIME OFF;
运行上述代码后,你会发现APPROX_COUNT_DISTINCT的执行时间显著低于COUNT DISTINCT。例如,在100万行数据中,精确计数可能需要几百毫秒甚至更久,而近似计数通常在几毫秒内完成。返回值方面,ExactCount会给出确切的整数,而ApproxCount会给出一个接近真实值的整数,两者差异通常很小。类型上,两者均返回bigint。这种性能优势在实时报表或交互式分析中尤为明显。
APPROX_COUNT_DISTINCT在分组统计中的行为特征是什么
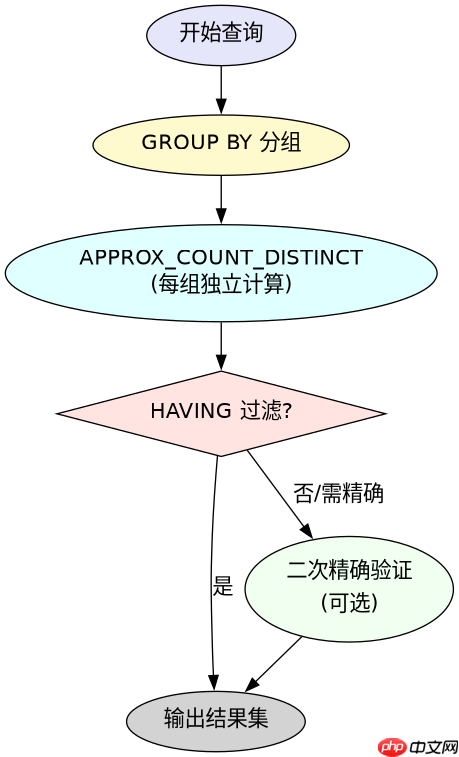
当结合GROUP BY使用时,APPROX_COUNT_DISTINCT会对每个组独立计算近似基数,不会跨组累积误差。这意味着每个分组的统计都是独立的HyperLogLog实例,保证了局部数据的准确性。然而,由于它是近似算法,不同运行次数的结果可能会有微小波动,这在业务允许范围内是可接受的。此外,它不能与HAVING子句中的精确比较混合使用来过滤组,因为近似值的不确定性可能导致过滤条件失效。
-- 按月份分组统计近似客户数
SELECT
    DATEPART(MONTH, SaleDate) AS MonthNum,
    APPROX_COUNT_DISTINCT(CustomerID) AS MonthlyUniqueCustomers
FROM SalesData
GROUP BY DATEPART(MONTH, SaleDate)
ORDER BY MonthNum;

-- 尝试使用HAVING过滤(注意:这里比较的是近似值)
SELECT
    DATEPART(MONTH, SaleDate) AS MonthNum,
    APPROX_COUNT_DISTINCT(CustomerID) AS MonthlyUniqueCustomers
FROM SalesData
GROUP BY DATEPART(MONTH, SaleDate)
HAVING APPROX_COUNT_DISTINCT(CustomerID) > 5000;
在上述分组查询中,每个月份的近似客户数是独立计算的。如果某个月份的实际唯一客户数为5200,APPROX_COUNT_DISTINCT可能返回5100或5300,这取决于内部随机种子和哈希分布。在HAVING子句中,虽然语法允许,但由于近似值的不确定性,建议仅在阈值宽松时使用。若需严格过滤,应先获取近似值,再对符合条件的组进行二次精确验证。这种两步走策略平衡了性能和精度。
当APPROX_COUNT_DISTINCT遇到NULL值时会如何处理
APPROX_COUNT_DISTINCT会自动忽略NULL值,这与COUNT(DISTINCT column)的行为一致。也就是说,只有非NULL的唯一值会被纳入估算。如果一列全部为NULL,函数将返回0。这一特性使得它在处理包含缺失值的数据集时无需额外预处理。然而,需要注意的是,NULL值不参与基数计算,因此不会影响HyperLogLog桶的填充状态,也不会引入额外的误差源。在实际应用中,若需区分“无数据”和“零值”,应确保数据模型中零值是显式存储的,而非NULL。





















