








使用 last30days 时,先在 Agent 会话写清主题、时间范围和希望采用的来源,再让它检索、判断候选并综合。以 agent browser 为例,可以先查最近 7 天的 HN 讨论,再打开原始链接核对项目身份与证据。
把第一次研究限制在一个能核对的问题
在已经加载好对应技能的项目会话里,直接输这条指令就行:“$last30days 研究 agent browser 最近 7 天的讨论,优先用 hacker news 来源。每条结论后面附上日期与原始链接,区分开开发者官方说明和评论者的个人使用经历,结果太少的话直接说明就行。”把范围卡到这个程度,后面出的所有内容都能逐条核对,不容易出乱子。
提前按照技能运行说明做好查询计划,再让引擎调取内容取证。计划里写清楚本次研究意图、检索关键词、相关性判断标准、可用的信息源,就能避免Agent把“浏览器自动化工具”误识别成普通浏览器的无关内容。
调试时怎样直接运行同一条查询
想直接看引擎的实际运行逻辑,调用脚本是最省事的方式。先进项目根目录,把下面的JSON内容存为 query-plan.json,再执行后面的完整命令就可以。平时正常用这个技能的时候,这份查询计划会自动生成,不用手动写。
{
  "intent": "product",
  "freshness_mode": "strict_recent",
  "cluster_mode": "story",
  "subqueries": [
    {
      "label": "primary",
      "search_query": "agent-browser",
      "ranking_query": "What recent practical experience and issues are reported about the agent-browser browser automation CLI?",
      "sources": ["hackernews"],
      "weight": 1.0
    }
  ]
}
python3 .agents/skills/last30days/scripts/last30days.py "agent browser" \
  --search hackernews --quick --days 7 --emit md \
  --plan query-plan.json --save-dir ./research/agent-browser \
  --no-browser-cookies
这次运行引擎最后只返回1条有效候选,同时提示证据量不足。看运行日志能看到完整的全流程:检索内容、剔除弱相关条目、提取有效评论。参数里的--quick用来加快首轮检查速度,--search用来限定信息来源,--no-browser-cookies是禁止本轮读取浏览器Cookie。
在对话窗口输入第一次研究问题
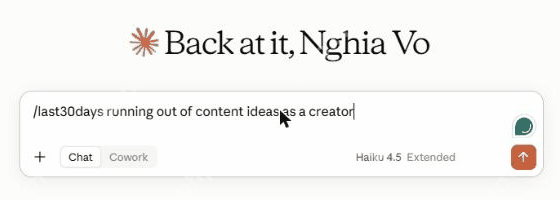
技能加载后,新建对话,输入 /last30days 加上研究主题就行。比如研究创作者为什么缺少内容选题,可以输入 /last30days running out of content ideas as a creator。网页端案例使用的是较早的 3.25.0 版本;本篇前面的命令行参数仍以当前安装版本为准。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
回答追问,把研究对象说清楚
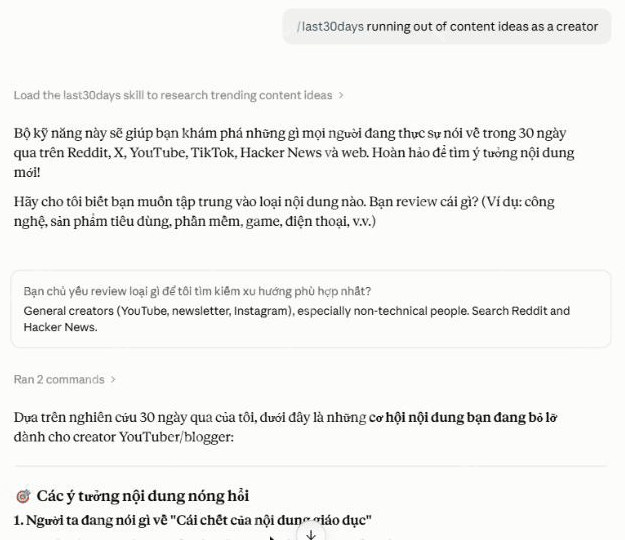
助手追问研究对象细节时,补充读者类型与来源范围,再继续执行就行。这个案例补充了面向普通创作者、优先研究 Reddit 和 Hacker News,能减少把宽泛问题理解成另一类选题的概率。
展开 Ran a command 核对实际执行
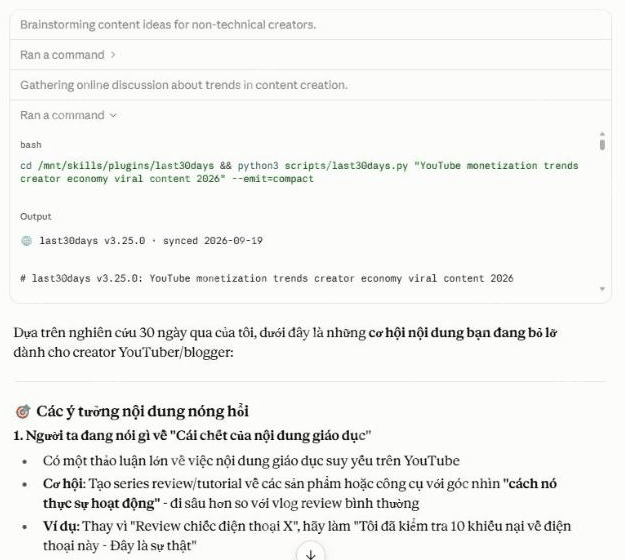
点击对话里的 Ran a command,展开命令与输出,核对主题是否偏移、哪些来源返回了结果。案例中的实际调用已转向 YouTube 变现趋势,因此不能直接把回答当成原问题的可靠结论。发现偏移就缩小主题重新查询,再核对原始链接。

记录结构化的Claude Code轨迹、影子git diff,并在代理行为需要法医级调试而非临时转录审查时回放分支。
打开结果后先核对项目,再读评论
拿到结果先从候选的标题和链接开始核对。这次运行返回的内容主体是 Agweb,如果你的研究目标是特定的 agent-browser 仓库,要把这类相关的无关讨论单独标记出来,再接着找对应项目的一手资料。所有候选里的评论,都只代表发布者当时的个人观点。
接着逐一检查内容的发布时间,确认都落在你之前指定的时间范围内,再挨个点开链接确认能不能正常访问,有没有重复引用同一条讨论的情况。原帖的热度、报告里的排序分值都只是用来初筛线索的,最后下结论一定要结合原文的实际内容判断。
把每条候选核对成可以引用的记录
先确认链接指向的项目或讨论对象,再检查发布日期,最后读支持结论的原句。评论者描述的个别失败,只能记为一次使用经历;要写成普遍问题,需要更多独立材料佐证。若候选只是同类工具,单独归入背景资料,别放进目标项目的更新列表。
追问时要求助手逐条区分“原帖明确说了什么”和“根据材料作出的推断”。没有原始链接的条目先搁置,重复引用同一来源的内容只算一份证据。这样整理之后,后续写教程或做选型才有可复查的起点。
怎样追问并补齐缺口
要是证据不够,直接发指令追问就行:“把直接关联目标仓库的内容单独列出来,说明现在哪些地方证据不足,再补充拉取 GitHub 上的近期 Issues。”后面如果要扩大信息来源、拉长检索的时间窗口,记得保留第一轮的原始记录,不要把7天和30天的检索样本混到同一张统计表里。
脚本运行前如果提示要传入查询计划,按照技能运行说明加上 --plan 参数就可以。如果出现数据源连接失败的情况,先做一次单源健康检查排查问题,千万别因为返回结果太少,就拿开发测试用的模拟数据往真实结论里凑。
























