








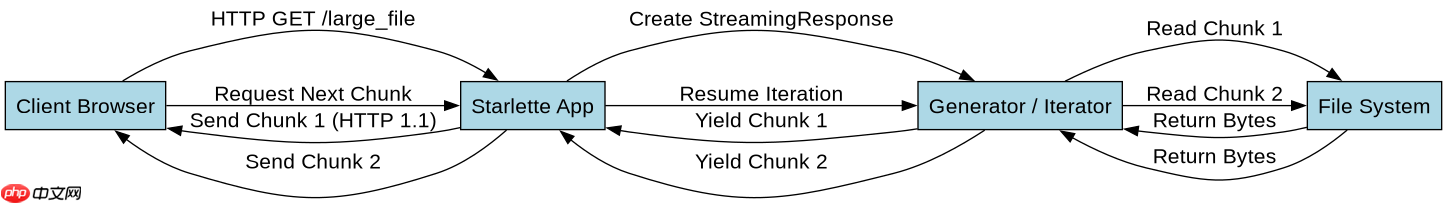
starlette 处理大规模文件分发的核心做法是避免将文件内容一次性加载到内存,而是利用 python 的生成器(generator)或异步迭代器实现流式传输。开发者需要创建一个返回文件块或文件对象的异步可迭代对象,并将其作为 streamingresponse 的输入参数。这样做可以确保服务器以极低的内存占用持续向客户端发送数据,同时支持 http 1.1 的分块传输编码(chunked transfer encoding),从而适应大文件的网络分发。
如何构建支持断点续传的文件响应
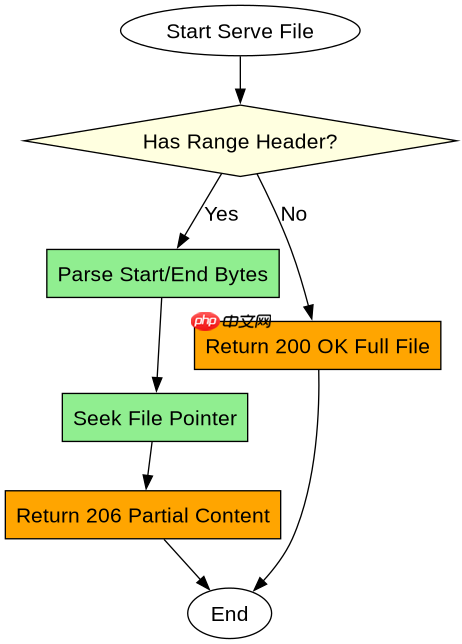
要实现支持断点续传的大规模文件分发,必须解析请求头中的 Range 字段,计算正确的字节范围,并设置相应的 Content-Range 和 206 Partial Content 状态码。如果请求未指定范围,则返回完整的 200 OK 响应。关键在于使用 seek() 定位文件指针,并通过生成器只 yield 指定范围内的数据块,而不是读取整个文件。
import os
from starlette.applications import Starlette
from starlette.responses import StreamingResponse
from starlette.requests import Request

def file_iterator(file_obj, start, end, chunk_size=8192):
    file_obj.seek(start)
    while start < end:
        data = file_obj.read(min(chunk_size, end - start))
        if not data:
            break
        start += len(data)
        yield data

app = Starlette()

@app.route("/files/{filename}")
async def serve_file(request: Request):
    filename = request.path_params["filename"]
    filepath = f"./uploads/{filename}"

    # 获取文件大小
    file_size = os.path.getsize(filepath)

    # 解析 Range 头
    range_header = request.headers.get("range")

    if range_header:
        # 简单解析 Range: bytes=start-end
        byte_range = range_header.replace("bytes=", "").split("-")
        start = int(byte_range[0])
        end = int(byte_range[1]) if byte_range[1] else file_size - 1

        response = StreamingResponse(
            file_iterator(open(filepath, "rb"), start, end),
            status_code=206,
            headers={
                "Content-Range": f"bytes {start}-{end}/{file_size}",
                "Accept-Ranges": "bytes",
                "Content-Length": str(end - start + 1)
            }
        )
    else:
        response = StreamingResponse(
            iter([open(filepath, "rb")]),
            headers={
                "Content-Length": str(file_size),
                "Accept-Ranges": "bytes"
            }
        )

    return response
上述代码展示了如何处理 Range 请求。当客户端发送 Range: bytes=0-1023 时,服务器会定位到文件开头,仅读取前 1024 字节并返回 206 状态码。这允许客户端在连接中断后从断点继续下载,而无需重新下载整个文件。对于不支持断点续传的旧客户端,代码回退到全量流式传输。
Starlette 1.5.1 是轻量级 Python ASGI 框架与工具集,提供路由、请求响应、中间件、WebSocket 和后台任务等组件,适合构建异步 Web 服务。本下载为官方 PyPI 通用 wheel 包,可使用 pip 安装,并由包管理器处理依赖;运行应用时还需配置 ASGI 服务器。
如何优化高并发下的文件句柄管理
在高并发场景下,频繁打开和关闭文件句柄会导致资源竞争和性能瓶颈。Starlette 本身不缓存文件内容,但可以通过预分配文件描述符或使用内存映射(mmap)来优化 I/O 操作。更常见的做法是结合 CDN 或对象存储(如 S3)进行分发,Starlette 仅作为元数据网关。若必须在本地分发,应确保文件路径校验严格,防止目录遍历攻击,并使用线程池或进程池隔离文件 I/O 阻塞操作,避免影响异步事件循环。
# 注意:此代码为概念验证,实际生产环境建议使用 aiofiles 或集成 S3
import aiofiles
from starlette.responses import StreamingResponse

async def async_file_iterator(filepath, chunk_size=8192):
    async with aiofiles.open(filepath, mode='rb') as f:
        while True:
            chunk = await f.read(chunk_size)
            if not chunk:
                break
            yield chunk

# 在路由中使用
@app.route("/secure/{filename}")
async def secure_serve(request: Request):
    filename = request.path_params["filename"]
    # 安全校验:防止 ../ 等路径遍历
    safe_name = os.path.basename(filename)
    filepath = os.path.join("./safe_uploads", safe_name)

    if not os.path.exists(filepath):
        return {"error": "File not found"}, 404

    return StreamingResponse(
        async_file_iterator(filepath),
        media_type="application/octet-stream"
    )
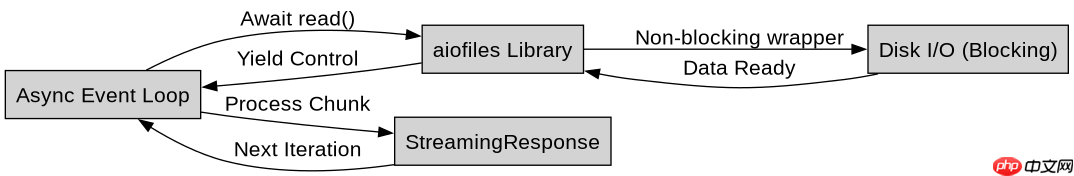
使用 aiofiles 库可以将同步的文件 I/O 操作转换为异步操作,从而不会阻塞 Starlette 的事件循环。这在处理数千个并发连接时尤为重要。每个连接独立打开文件流,避免了共享状态导致的竞态条件。同时,通过 os.path.basename 过滤文件名,确保用户无法访问系统敏感文件。
当文件超过可用内存时如何防止 OOM
当文件体积远超服务器可用内存时,任何试图将整个文件读入列表或字符串的操作都会导致 Out Of Memory (OOM) 错误。Starlette 的 StreamingResponse 天然支持这种场景,因为它基于迭代器协议,每次只处理一个数据块。关键在于确保生成器函数中使用的缓冲区大小(chunk size)远小于可用内存,并且不要在任何中间步骤累积数据。例如,严禁使用 yield from open(...).readlines(),而应使用逐行或逐块读取的方式。此外,应监控服务器的内存使用情况,并在极端情况下限制单个连接的最大下载速率或超时时间,以防止恶意用户耗尽资源。






















