








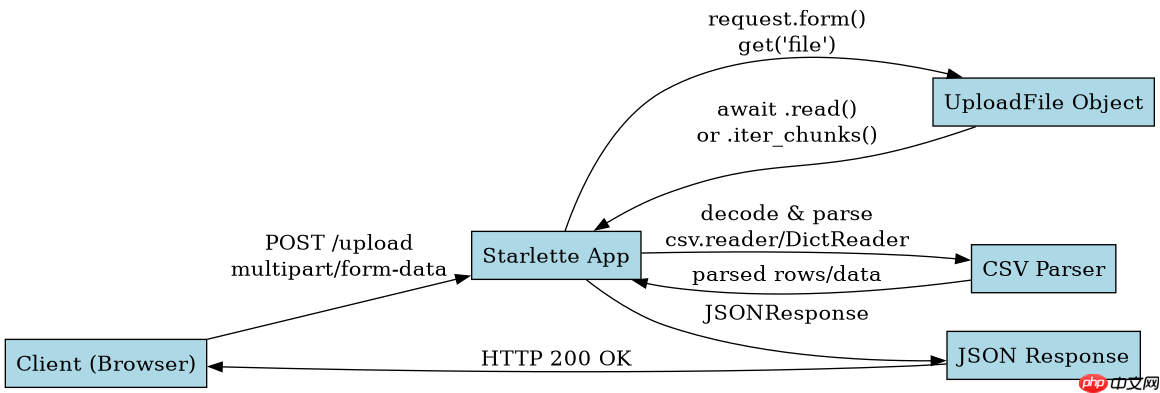
starlette 上传 csv 文件并解析的核心做法是接收 uploadfile 对象,读取其内容到内存或临时文件,然后使用 python 标准库的 csv 模块进行解析。具体实现时,在路由处理函数中获取请求中的文件字段,调用 .read() 方法获取字节流,解码为字符串后传入 csv.reader 或 io.stringio 包装器。这样做可以直接获得行迭代器,便于后续转换为字典列表或直接存入数据库。需要注意的是,如果文件极大,应使用 .iter_read() 分块读取以避免内存溢出,且必须指定正确的字符编码(通常为 utf-8)以防乱码。
如何定义接收 CSV 上传的路由和处理函数
在 Starlette 中,定义接收文件上传的路由需要使用 Request 对象来访问表单数据。通过 request.form() 可以获取包含文件的表单字段,返回的是 FormData 对象。接着,通过键名获取具体的 UploadFile 实例。这个实例提供了 filename、content_type 以及读取内容的多种方法。开发者需要确保 HTML 表单的 enctype 属性设置为 multipart/form-data,否则文件无法正确传输。处理函数的返回值通常是一个 JSON 响应,包含解析后的数据或状态码。
from starlette.applications import Starlette
from starlette.responses import JSONResponse
from starlette.routing import Route
from starlette.requests import Request
import csv
import io

async def upload_csv(request: Request):
    try:
        # 获取表单中的文件字段
        form = await request.form()
        file = form.get("file")

        if not file or file.filename == "":
            return JSONResponse({"status": "error", "message": "No file selected"}, status_code=400)

        # 读取文件内容
        content = await file.read()

        # 解码并解析 CSV
        text_content = content.decode("utf-8")
        reader = csv.reader(io.StringIO(text_content))
        rows = list(reader)

        if not rows:
            return JSONResponse({"status": "empty"}, status_code=200)

        # 假设第一行是表头
        headers = rows[0]
        data = []
        for row in rows[1:]:
            if len(row) == len(headers):
                data.append(dict(zip(headers, row)))
            else:
                # 处理列数不匹配的行
                pass

        return JSONResponse({"status": "success", "rows": len(data), "data": data[:5]})
    except Exception as e:
        return JSONResponse({"status": "error", "message": str(e)}, status_code=500)

routes = [
    Route("/upload", endpoint=upload_csv, methods=["POST"])
]

app = Starlette(routes=routes)
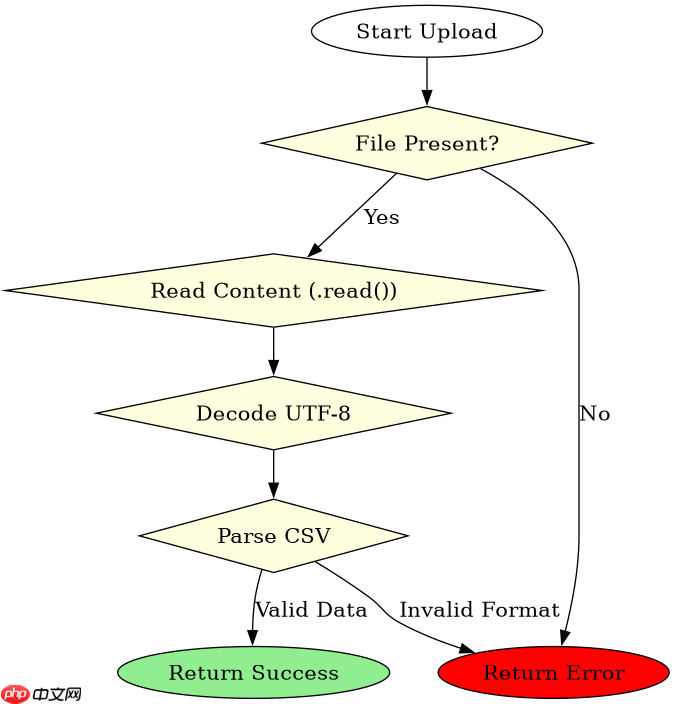
上述代码展示了完整的处理流程。首先检查文件是否存在,然后一次性读取全部内容。对于小文件,这是最高效的方式。解析过程中,使用 csv.reader 处理原始文本,然后通过 zip 函数将表头和每一行数据组合成字典。最后返回前 5 条数据作为示例响应。如果发生异常,如编码错误或格式错误,会捕获并返回错误信息。

如何处理大文件上传以避免内存溢出
当上传的 CSV 文件非常大时,直接使用 .read() 会将整个文件加载到内存中,可能导致 MemoryError。Starlette 的 UploadFile 对象支持异步迭代和分块读取。最佳实践是使用 .iter_read(chunk_size) 方法,每次只读取固定大小的字节块。这些块需要累积在一个缓冲区中,或者逐行处理。由于 csv 模块通常期望字符串输入,我们需要将字节块解码为字符串,并小心处理跨块的换行符问题。一种更稳健的方法是将文件保存到临时位置,然后使用标准的 open 函数以文本模式打开并逐行读取,这样操作系统和文件系统会协助管理内存。
import tempfile
import os
import csv

async def upload_large_csv(request: Request):
    form = await request.form()
    file = form.get("file")

    if not file:
        return JSONResponse({"status": "error"}, status_code=400)

    # 创建临时文件
    with tempfile.NamedTemporaryFile(delete=False, suffix=".csv") as tmp_file:
        tmp_path = tmp_file.name
        # 分块写入临时文件
        async for chunk in file.iter_chunks():
            tmp_file.write(chunk)

    try:
        # 从临时文件读取并解析
        with open(tmp_path, "r", encoding="utf-8") as f:
            reader = csv.DictReader(f)
            # 这里可以逐行处理,避免加载所有数据到内存
            first_row = next(reader, None)

        return JSONResponse({"status": "success", "has_data": first_row is not None})
    finally:
        # 清理临时文件
        os.unlink(tmp_path)
这段代码演示了基于临时文件的策略。首先,通过 iter_chunks() 异步读取上传文件的字节块,并写入一个临时文件。这确保了即使文件很大,内存占用也保持在较低水平。写入完成后,使用标准的 open 函数打开该临时文件,并使用 csv.DictReader 进行解析。DictReader 会自动将第一行作为键,后续行作为值,生成字典。这种方式不仅节省内存,而且代码简洁。最后,务必在 finally 块中删除临时文件,防止磁盘空间泄漏。这种方法适用于任何大小的 CSV 文件,是生产环境中的推荐做法。
如果 CSV 文件中包含非 UTF-8 编码的数据会怎样
如果 CSV 文件包含非 UTF-8 编码的数据(例如 GBK 或 Latin-1),直接调用 .decode("utf-8") 会抛出 UnicodeDecodeError 异常,导致解析失败。Starlette 本身不自动检测编码,因此开发者必须预先知道或使用启发式方法猜测编码。常见的解决方案是尝试多种编码进行解码,或者使用第三方库如 chardet 来检测编码。一旦检测到正确的编码,再将其传递给 csv 解析器。如果不处理,程序将崩溃或返回错误响应。此外,某些 CSV 文件可能带有 BOM(Byte Order Mark),这也需要在解码后去除,否则表头名称会包含不可见字符,导致键名不匹配。
import chardet
import csv
import io

async def upload_mixed_encoding_csv(request: Request):
    form = await request.form()
    file = form.get("file")

    if not file:
        return JSONResponse({"status": "error"}, status_code=400)

    content = await file.read()

    # 检测编码
    detected = chardet.detect(content)
    encoding = detected["encoding"] or "utf-8"

    # 处理 BOM
    if content.startswith(b'\xef\xbb\xbf'):
        content = content[3:]
        # 重新检测,因为 BOM 可能影响检测结果
        detected = chardet.detect(content)
        encoding = detected["encoding"] or "utf-8"

    try:
        text_content = content.decode(encoding)
        reader = csv.DictReader(io.StringIO(text_content))
        rows = list(reader)
        return JSONResponse({"status": "success", "encoding": encoding, "rows": len(rows)})
    except UnicodeDecodeError:
        return JSONResponse({"status": "error", "message": "Failed to decode with detected encoding"}, status_code=400)
此代码片段展示了如何处理编码问题。首先,使用 chardet 库对原始字节内容进行编码检测。虽然 chardet 不是 100% 准确,但在大多数情况下能提供可靠的结果。检测到编码后,尝试使用该编码解码字节流。同时,代码还检查并移除了 UTF-8 BOM,这是一种常见的陷阱。如果解码失败,则返回错误。在实际应用中,还可以设置一个编码列表,按优先级尝试解码,直到成功为止。这种灵活性使得应用能够兼容不同来源的 CSV 文件,提高鲁棒性。


















