








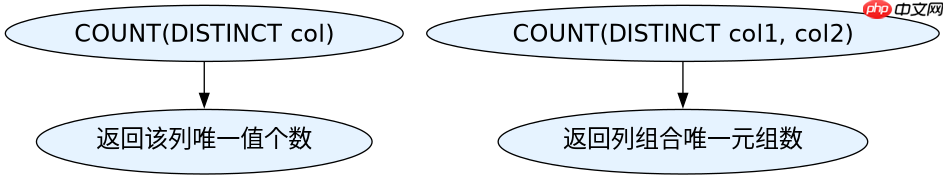
在navicat中统计去重后的数量,核心操作是在sql查询中使用 count(distinct 字段名) 函数。该函数会忽略 null 值,仅对指定列中唯一非空值的组合进行计数。若需基于多列去重,可将多列放入括号内,如 count(distinct col1, col2)。
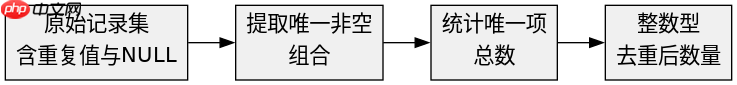
COUNT DISTINCT 的基本语法与执行逻辑
使用 COUNT(DISTINCT ...) 时,数据库引擎会在内存或临时表中构建一个哈希集合,将扫描到的值插入集合,重复值自动覆盖,最终返回集合大小。此过程不依赖索引排序,但受限于可用内存。若字段包含大量不同值,可能触发磁盘临时表。
-- 假设表 users 有 id, name, department 字段
SELECT COUNT(DISTINCT department) AS unique_depts
FROM users;

-- 输出示例:
-- unique_depts
-- 5
上述查询返回 users 表中不同部门数量的整数结果。若所有记录 department 均为 'HR',结果为 1;若存在 NULL,则不计入。注意:COUNT(DISTINCT) 不支持表达式直接嵌套,如需对计算结果去重,应先用子查询生成中间结果再外层聚合。
多列联合去重的行为差异
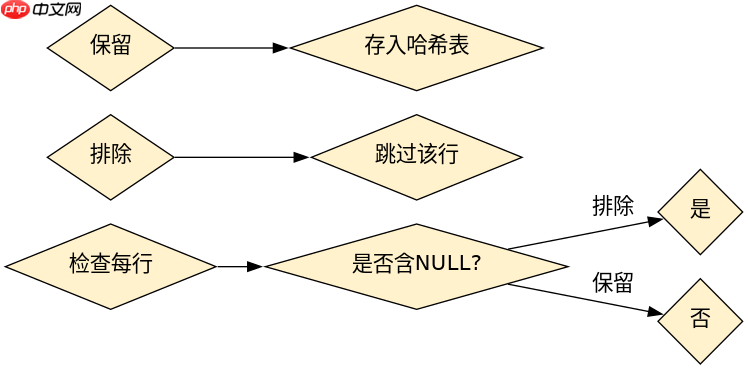
当传入多个列时,COUNT(DISTINCT col1, col2) 统计的是 (col1, col2) 组合的唯一性,而非各列独立去重后的总和。例如 (A, B) 和 (A, C) 视为两个不同组合,即使 A 相同。若某行 col1 为 NULL,该行参与组合判断,但整个元组若全为 NULL 仍被忽略。
-- 测试多列去重
CREATE TABLE test_multi (a INT, b VARCHAR(10));
INSERT INTO test_multi VALUES (1, 'x'), (1, 'y'), (2, 'x'), (1, NULL);

SELECT COUNT(DISTINCT a, b) AS combo_count FROM test_multi;
-- 结果: 3 (组合为 (1,'x'), (1,'y'), (2,'x');(1,NULL) 因含NULL被排除)

SELECT COUNT(DISTINCT a) AS a_unique FROM test_multi;
-- 结果: 2 (a 值为 1, 2)
对比可见,多列去重强调元组唯一性,单列去重仅关注单一字段。实际应用中,若需统计“有多少个不同的用户访问过不同页面”,应使用 COUNT(DISTINCT user_id, page_id) 而非分别计数后相加,后者会重复计算同一用户多次访问的情况。
处理包含 NULL 值时的边界情况
COUNT(DISTINCT)严格排除任何包含 NULL 的元组。即使其他列有值,只要参与去重的任一列为 NULL,该行即不参与计数。这与 COUNT(*) 或 COUNT(字段) 不同,后者对 NULL 的处理方式各异。建议在业务逻辑中明确是否允许 NULL 代表有效实体,必要时用 COALESCE 替换默认值后再去重。
















