








优化oracle data guard备库mrp(managed recovery process)延迟,核心在于提升备库的日志应用吞吐量并减少i/o瓶颈。具体做法包括:将备库置于最大性能模式(nologging或async传输),启用实时应用(real-time apply)以消除归档间隙,调整并行恢复进程数(parallel_max_servers及mrp相关参数),以及确保存储子系统具备足够的iops和带宽来应对重做日志流。若延迟由网络引起,需检查带宽利用率;若由磁盘io引起,需优化数据文件分布或使用更快的存储介质。

如何确认当前MRP进程的实时状态与延迟量级
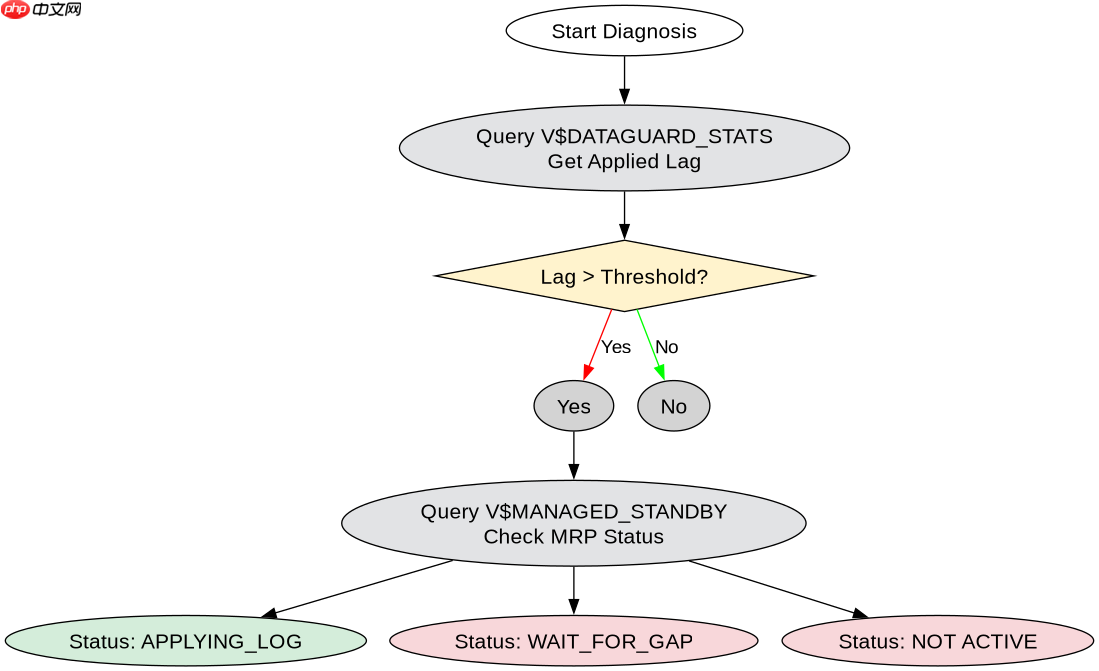
要量化延迟,必须查询V$DATAGUARD_STATS视图获取“Applied Lag”,并结合V$MANAGED_STANDBY查看MRP进程是否活跃。如果Applied Lag持续增加,说明MRP处理速度跟不上主库生成日志的速度。
SELECT NAME, VALUE, UNIT, TIME_COMPUTED, DATUM_TIME
FROM V$DATAGUARD_STATS
WHERE NAME IN ('apply lag', 'transport lag');

SELECT PROCESS, STATUS, THREAD#, SEQUENCE#, BLOCK#, BLOCKS
FROM V$MANAGED_STANDBY
WHERE PROCESS LIKE 'MRP%';
上述SQL执行后,重点关注apply lag的值。若单位为秒且数值较大(如超过300秒),则确认为严重延迟。同时检查V$MANAGED_STANDBY中MRP0进程的状态是否为APPLYING_LOG。若状态为WAIT_FOR_GAP,则说明存在日志缺失,而非单纯的吞吐问题。
如何通过调整并行度与存储I/O缓解高负载下的MRP延迟
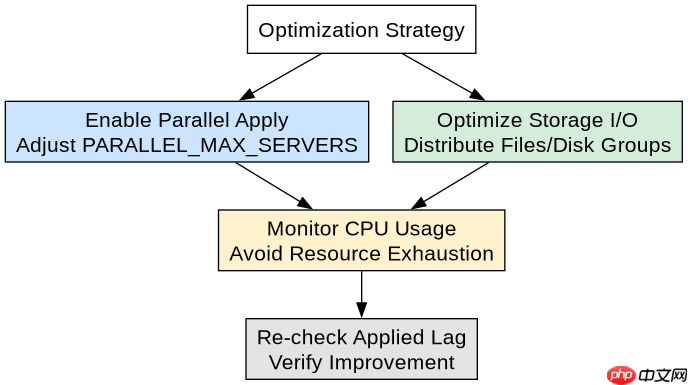
当主库事务量大导致日志生成速度快于单线程MRP的应用速度时,启用并行恢复是有效的优化手段。通过设置PARALLEL_MAX_SERVERS并确保备库初始化参数STANDBY_PARALLEL_APPLY(在RAC环境中)或依赖Oracle自动并行机制,可以加速Redo Apply过程。此外,将控制文件和重做日志分布在不同的磁盘组上,避免I/O争用。

-- 检查当前并行服务器限制
SHOW PARAMETER PARALLEL_MAX_SERVERS;

-- 在备库上尝试启动并行应用(如果尚未自动启用)
ALTER DATABASE RECOVER MANAGED STANDBY DATABASE PARALLEL;

-- 监控并行进程数量
SELECT COUNT(*) FROM V$PROCESS WHERE PROGRAM LIKE '%MRP%';
执行上述命令后,观察V$SESSION_LONGOPS中MRP相关的进度条变化。如果并行进程数显著增加且apply lag开始下降,说明I/O瓶颈已部分解除。需注意,并行恢复会增加CPU消耗,因此需监控备库CPU使用率,避免资源耗尽导致新的延迟。
基于MRP进程状态为WAIT_FOR_GAP的具体排查步骤
如果前两步发现MRP进程处于WAIT_FOR_GAP状态,这通常意味着备库缺少特定的归档日志序列号,导致无法连续应用。这种情况常见于网络中断、归档传输失败或手动删除了归档日志。此时,单纯调整并行度无效,必须解决日志连续性缺口。
-- 查询缺失的日志序列范围
SELECT * FROM V$ARCHIVED_LOG
WHERE DEST_ID = 2
AND SEQUENCE# BETWEEN (SELECT MIN(SEQUENCE#) FROM V$ARCHIVE_GAP)
                   AND (SELECT MAX(SEQUENCE#) FROM V$ARCHIVE_GAP);

-- 在主库上重新发送缺失的日志
ALTER SYSTEM ARCHIVE LOG CURRENT;

-- 或者手动注册缺失的日志文件到备库
ALTER DATABASE REGISTER LOGFILE '/path/to/missing/archive.log';
执行注册操作后,MRP进程应自动从WAIT_FOR_GAP切换回APPLYING_LOG。此时再次查询V$DATAGUARD_STATS,确认apply lag开始回落。若缺失日志过多,建议联系DBA团队检查主库归档路径的完整性,并考虑启用FAL_SERVER和FAL_CLIENT参数以实现自动故障转移和日志请求,防止此类人工干预场景再次发生。




















