








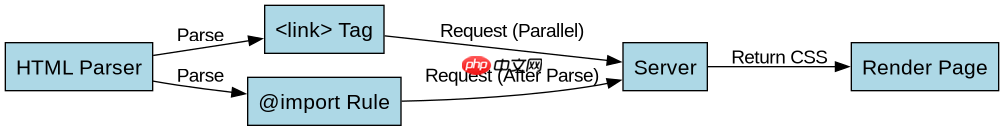
现代前端开发不推荐使用 @import 引入 css,核心原因是它会阻塞页面渲染并导致额外的网络请求往返。浏览器解析 html 时遇到 <link> 标签会立即发起并行请求,而遇到 @import 则必须等待当前样式表下载并解析完成后,才能开始处理导入的 url,这种串行机制显著增加了关键渲染路径的延迟。
<link> 与 @import 在加载时序上的具体差异是什么
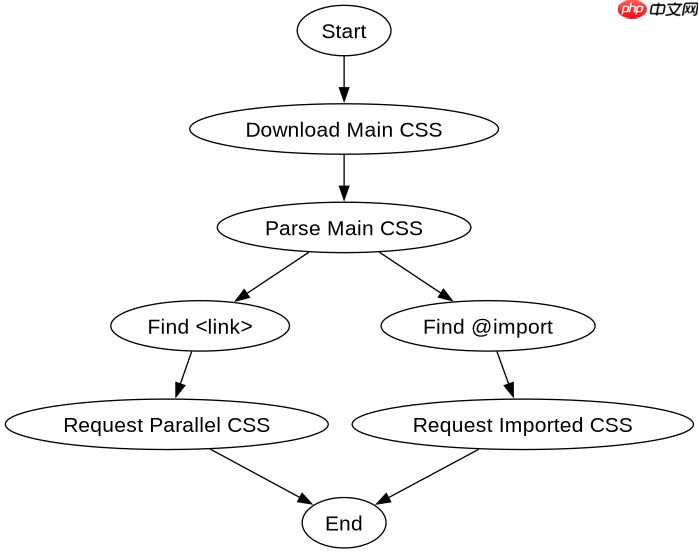
使用 <link> 标签引入样式表时,浏览器解析器发现该标签后会立即向服务器发起 HTTP 请求,且多个 <link> 可以并行下载。相比之下,CSS 文件本身也是文本资源,浏览器必须先下载完主样式表,解析其中的内容,识别到 @import 规则后,才会提取出新的 URL 并发起第二次请求。这种“先下载、再解析、后请求”的流程引入了不必要的等待时间。
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <title>CSS Import Test</title>
    <!-- 方式一:推荐,并行加载 -->
    <link rel="stylesheet" href="style.css">
    <link rel="stylesheet" href="theme.css">

    <!-- 方式二:不推荐,串行加载 -->
    <style>
        @import url('layout.css');
    </style>
</head>
<body>
    <h1>Hello World</h1>
</body>
</html>在上述代码中,style.css 和 theme.css 会被浏览器同时请求,而 layout.css 必须等待包含 @import 的 <style></style> 块解析完毕后才会被请求。如果 layout.css 较大或网络延迟较高,用户看到完整样式的等待时间将明显增加。
立即学习“前端免费学习笔记(深入)”;
为什么 @import 会导致重复下载和资源浪费
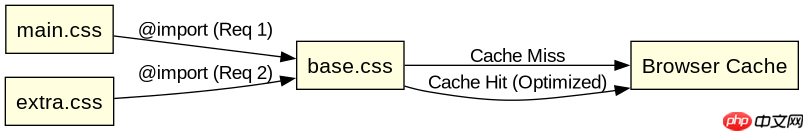
除了时序问题,@import 还会导致相同的样式文件被多次下载。当多个样式表通过 <code>@import 引用同一个基础库(如 reset.css)时,每个引用它的样式表都会独立触发一次对该文件的请求。浏览器无法像处理 <link> 那样智能地合并或去重这些请求,从而浪费了带宽和服务器资源。

阿拉丁·前端工程工坊把「前端只会写页面、规范停在文档里、脚手架手敲、构建靠抄、性能靠猜、可访问性靠忘」从「手动搭项目、抄配置、肉眼查规范」升级成一条本地工具链——多框架脚手架生成(React/Vue3/Svelte + Vite)、可复用组件生成(Props 类型+样式+示例)、规范落地检查(lint-lite:命名/未用变量/console残留/TS any/目录结构)、构建配置生成与产物体积预算、性能审计(依赖体积/重复/懒加载/Lighthouse 清单)、可访问性(a11y)校验(alt/aria
/* base.css */
h1 { color: red; }

/* main.css */
@import url('base.css');
p { color: blue; }

/* extra.css */
@import url('base.css');
div { margin: 0; }在这个示例中,base.css 会被下载两次。第一次是 main.css 解析后请求它,第二次是 extra.css 解析后请求它。如果使用 <link> 标签直接在 HTML 中引入 base.css、main.css 和 extra.css,浏览器只会下载一次 base.css 并利用缓存机制复用,从而减少网络开销。
在构建工具中如何处理 CSS 依赖关系
既然原生 CSS 的 @import 存在性能缺陷,现代前端工程化通常借助构建工具(如 Webpack、Vite)来解决依赖管理问题。这些工具允许开发者在 JS 或 CSS 中使用模块化的 import 语法,并在构建阶段自动分析依赖图,将分散的样式文件合并、压缩并优化加载顺序,从而规避原生浏览器的限制。
例如,在 Vite 项目中,你可以在 JavaScript 文件中直接导入 CSS:
import './styles/main.css';
import './styles/theme.css';
Vite 会在开发模式下将这些 CSS 注入到 HTML 中,在生产模式下则会自动将它们打包成独立的 CSS 文件,并通过 <link> 标签以最优方式引入。这种方式既保留了模块化开发的便利性,又避免了 @import 带来的性能陷阱。





















