








starlette 使用依赖注入管理数据库连接的核心做法是定义一个返回连接对象的异步函数,并将其作为参数传入路由或视图函数中。通过 starlette 的 `depends` 机制,框架会在请求生命周期内自动调用该函数获取连接,并在请求结束后执行清理逻辑,从而实现连接的有效管理和复用。

如何定义并注册依赖函数
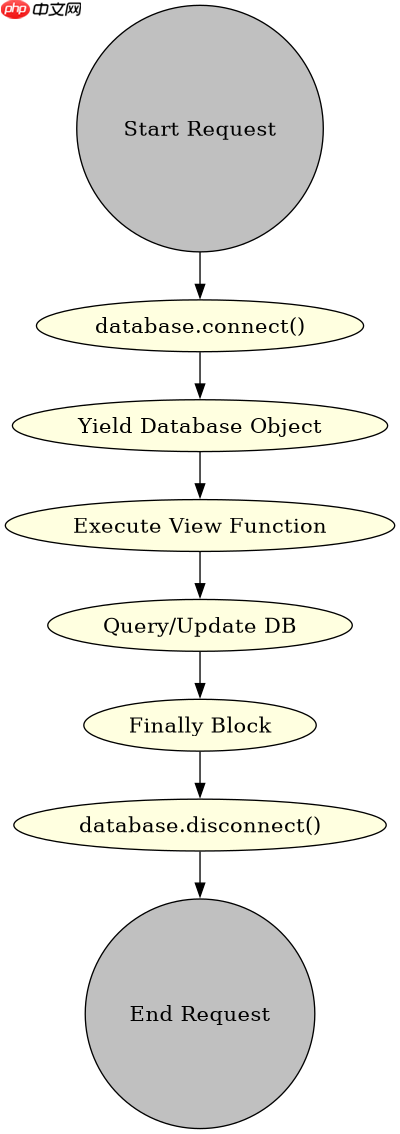
要开始使用依赖注入,首先需要创建一个负责建立和关闭数据库连接的异步函数。这个函数通常被标记为依赖项,以便 Starlette 能够识别它。在函数内部,你可以初始化数据库客户端实例,例如 SQLAlchemy 的 AsyncEngine 或 AsyncSession。关键在于,你需要确保在请求结束时正确释放资源,这通常通过在依赖函数中使用 yield 语句来实现,或者在应用启动和关闭事件中管理连接池的生命周期。
from starlette.applications import Starlette
from starlette.routing import Route
from starlette.requests import Request
from contextlib import asynccontextmanager
import databases

# 假设使用 databases 库
DATABASE_URL = "sqlite+aiosqlite:///./test.db"
database = databases.Database(DATABASE_URL)

@asynccontextmanager
async def get_db(request: Request):
    # 连接数据库
    await database.connect()
    try:
        # 将连接对象传递给视图函数
        yield database
    finally:
        # 请求结束后断开连接
        await database.disconnect()

async def users_endpoint(request: Request):
    db = request.scope['db']
    # 使用 db 进行查询
    return {"status": "ok"}

app = Starlette(routes=[
    Route("/users", users_endpoint, methods=["GET"])
])

# 注意:实际使用中通常结合 Depends 使用,见下文完整示例
上述代码展示了基本的连接管理逻辑。在实际应用中,我们更倾向于使用 starlette.dependencies.Depends 来简化这一过程。通过将 get_db 函数包装在 Depends 中,Starlette 会自动处理依赖解析。当请求到达时,Starlette 会调用 get_db,等待其 yield 出连接对象,然后将该对象注入到视图函数的参数中。一旦视图函数执行完毕,Starlette 会继续执行 get_db 中 yield 之后的代码,即断开连接。这种模式确保了每个请求都有独立的连接上下文,避免了连接泄漏。
如何在路由中集成依赖注入
在路由定义中集成依赖注入非常简单,只需在视图函数的参数列表中添加带有 Depends 的参数即可。Starlette 的路由系统会自动检测这些依赖项,并在调用视图函数之前先解决它们。这意味着你不需要手动传递数据库连接,也不需要在全局变量中维护连接状态。这种方式不仅使代码更加模块化,还提高了可测试性,因为你可以轻松地在单元测试中替换掉真实的数据库依赖。
Starlette 1.5.1 是轻量级 Python ASGI 框架与工具集,提供路由、请求响应、中间件、WebSocket 和后台任务等组件,适合构建异步 Web 服务。本下载为官方 PyPI 通用 wheel 包,可使用 pip 安装,并由包管理器处理依赖;运行应用时还需配置 ASGI 服务器。
from starlette.applications import Starlette
from starlette.routing import Route
from starlette.requests import Request
from starlette.responses import JSONResponse
from starlette.dependencies import Depends
import databases

DATABASE_URL = "sqlite+aiosqlite:///./test.db"
database = databases.Database(DATABASE_URL)

async def get_db():
    await database.connect()
    try:
        yield database
    finally:
        await database.disconnect()

async def users_endpoint(request: Request, db=Depends(get_db)):
    # db 参数现在包含了数据库连接对象
    query = "SELECT * FROM users"
    rows = await db.fetch_all(query)
    return JSONResponse(content=[dict(row) for row in rows])

app = Starlette(routes=[
    Route("/users", users_endpoint, methods=["GET"])
])

# 运行应用前需确保数据库表已创建
# uvicorn main:app
在这个完整的示例中,users_endpoint 函数接收两个参数:request 和 db。db 参数的默认值是通过 Depends(get_db) 指定的。当请求到达 /users 路径时,Starlette 首先调用 get_db 函数。该函数建立数据库连接并通过 yield 返回连接对象。随后,Starlette 将这个连接对象赋值给 db 参数,并调用 users_endpoint。视图函数执行完毕后,Starlette 恢复对 get_db 的执行,触发 finally 块中的断开连接逻辑。整个过程对用户透明,且保证了连接的正确生命周期管理。
如何处理并发请求下的连接池限制
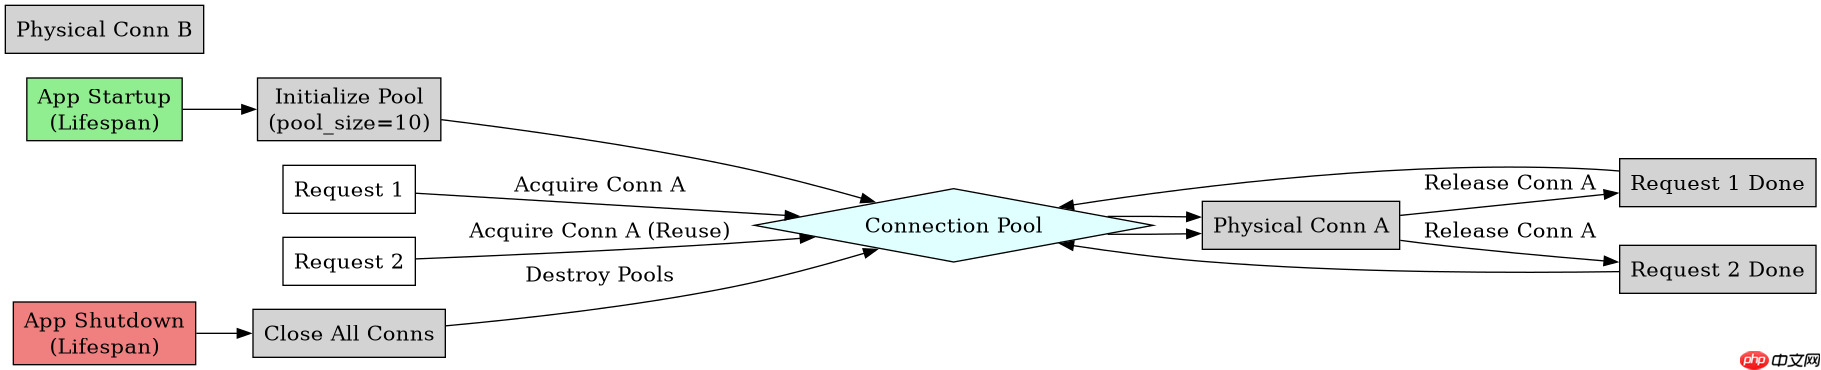
在高并发场景下,如果每个请求都创建一个新的物理数据库连接,可能会导致数据库服务器连接数耗尽。因此,使用连接池(Connection Pool)是必要的。大多数现代异步数据库驱动(如 aiomysql, asyncpg, databases 等)都内置了连接池功能。在 Starlette 的依赖注入模式中,连接池通常在应用启动时初始化,并在整个应用生命周期内共享。依赖函数从池中获取一个连接,而不是创建新连接。这样,多个请求可以复用少量的物理连接,从而提高效率并防止资源耗尽。
import databases

# 配置连接池大小
DATABASE_URL = "postgresql+asyncpg://user:password@localhost/dbname"
database = databases.Database(DATABASE_URL, pool_size=10, max_overflow=20)

async def get_db():
    # 从池中获取一个连接
    async with database.connection() as conn:
        yield conn

# 在应用启动时连接池初始化
async def lifespan(app):
    await database.connect()
    yield
    await database.disconnect()

from starlette.applications import Starlette
app = Starlette(lifespan=lifespan)
在上述代码中,pool_size 和 max_overflow 参数控制了连接池的行为。pool_size 定义了池中保持打开的最小连接数,而 max_overflow 允许在需要时临时创建额外的连接。依赖函数 get_db 使用 async with 语句从池中获取连接。当 async with 块结束时,连接会自动返回到池中,而不是被销毁。这使得同一个物理连接可以被多个请求顺序复用,极大地提高了系统的吞吐量和稳定性。此外,通过 lifespan 事件管理器,我们可以确保在应用启动时初始化连接池,在应用关闭时安全地关闭所有连接,避免资源泄漏。





















