








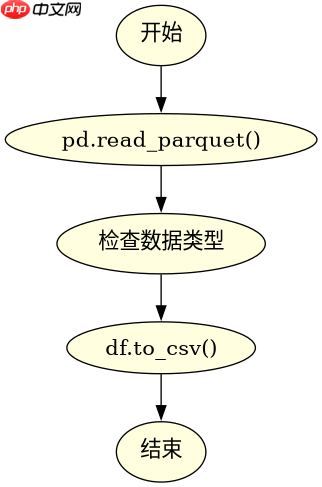
navicat 本身不直接支持导入 parquet 文件,必须先将 parquet 转换为 csv 或 sql 格式。具体做法是使用 python 的 pandas 库读取 parquet 并导出为 csv,然后在 navicat 中使用“数据传输”功能将 csv 导入目标数据库。

如何将 Parquet 转换为 CSV 以便 Navicat 识别
使用 pandas.read_parquet() 读取源文件,并通过 to_csv() 指定编码和分隔符生成中间文件。这一步解决了数据格式不兼容的问题,确保生成的 CSV 包含表头且无乱码。
import pandas as pd

# 读取 Parquet 文件
df = pd.read_parquet('data.parquet')

# 导出为 UTF-8 编码的 CSV,逗号分隔
df.to_csv('data.csv', index=False, encoding='utf-8-sig')
运行上述代码后,会在当前目录生成 data.csv。该文件可直接被 Navicat 的数据传输工具识别。注意使用 utf-8-sig 编码可以防止 Excel 或某些数据库客户端打开时出现 BOM 头导致的列错位问题。
在 Navicat 中配置数据传输以导入 CSV
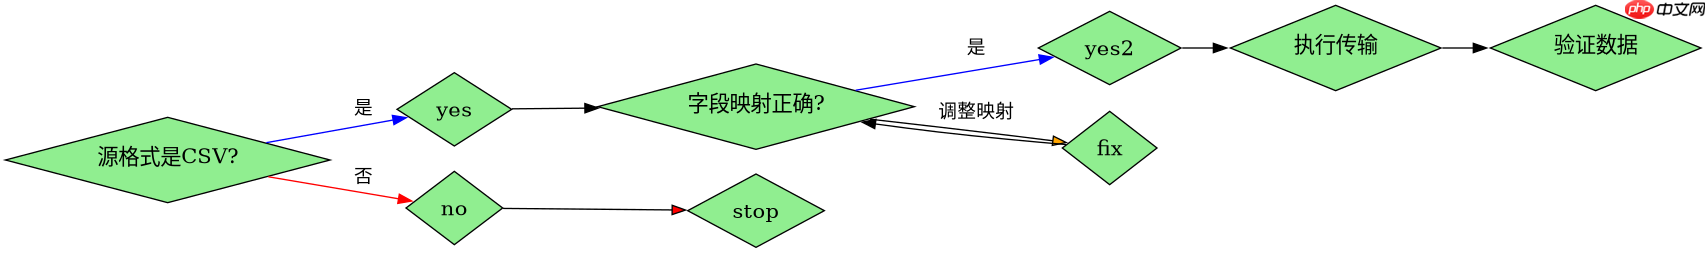
打开 Navicat 连接目标数据库,点击菜单栏的“工具”->“数据传输”。在源选择中选择“文件”,格式选 CSV;目标选择对应的表和字段映射。此步骤完成了从文件系统到数据库表的物理迁移。
-- 假设目标表结构已创建
CREATE TABLE target_table (
    id INT,
    name VARCHAR(50),
    value DOUBLE
);

-- 在 Navicat 界面操作:
-- 1. 工具 -> 数据传输
-- 2. 源:文件 -> data.csv
-- 3. 目标:本地数据库 -> target_table
-- 4. 勾选“覆盖现有表”或“追加记录”
-- 5. 执行
在数据传输向导中,务必检查字段类型映射是否正确,特别是数值型和日期型字段。如果 Parquet 中包含空值,CSV 中的空白单元格会被视为 NULL,需确保目标表允许 NULL 值或设置默认值。执行完成后,可通过查询语句验证数据行数是否一致。
Parquet 中的嵌套结构在 CSV 转换中如何处理
当 Parquet 文件包含嵌套结构(如 JSON 或数组)时,pandas 会将其转换为字符串表示。例如,列表 [1, 2] 会变成字符串 "[1, 2]"。这种处理方式保持了数据的可读性,但后续在数据库中可能需要进一步解析。




















