








gamer论文披露了面向实时游戏交互的streaming-vllm推理优化。在nvidia h200上使用qwen3.5-35b-a3b moe模型时,表9的完整请求延迟由基线1306.00毫秒降至最终配置65.12毫秒。两端配置包含tp1到tp4的变化及多项累计优化,因此不能把约20倍的差距解释为同一硬件数量下某一个算子的独立加速效果。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
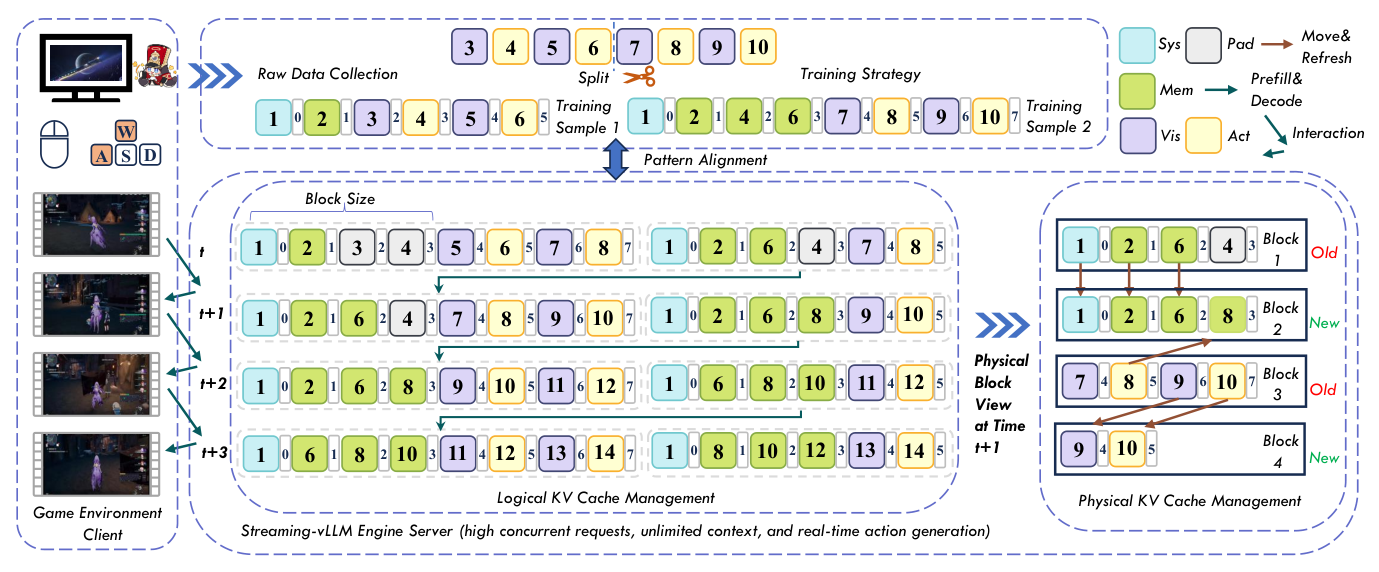
论文原图中的流式交互与KV缓存组织。
连续交互需要保留状态
实时游戏会不断送入新画面并生成下一段动作。Streaming-vLLM围绕这种连续轨迹管理逻辑与物理KV缓存,复用可保留的上下文,同时处理新观察与动作片段。系统优化目标是缩短完整交互路径,而不只是提高一段长文本的平均生成速度。
低延迟来自多个环节叠加
表9从TP1基线开始,加入TP4有状态流式引擎后,总延迟仍为1264.76毫秒;继续加入算子融合、并行重叠、CUDA Graph、Megakernel、部分W8A8量化和引导解码,才达到65.12毫秒。最后一项还结合有限状态机引导及BF16目标模型校验。论文明确指出,不同配置的分析边界也可能变化,应把表格理解为累计系统演进。

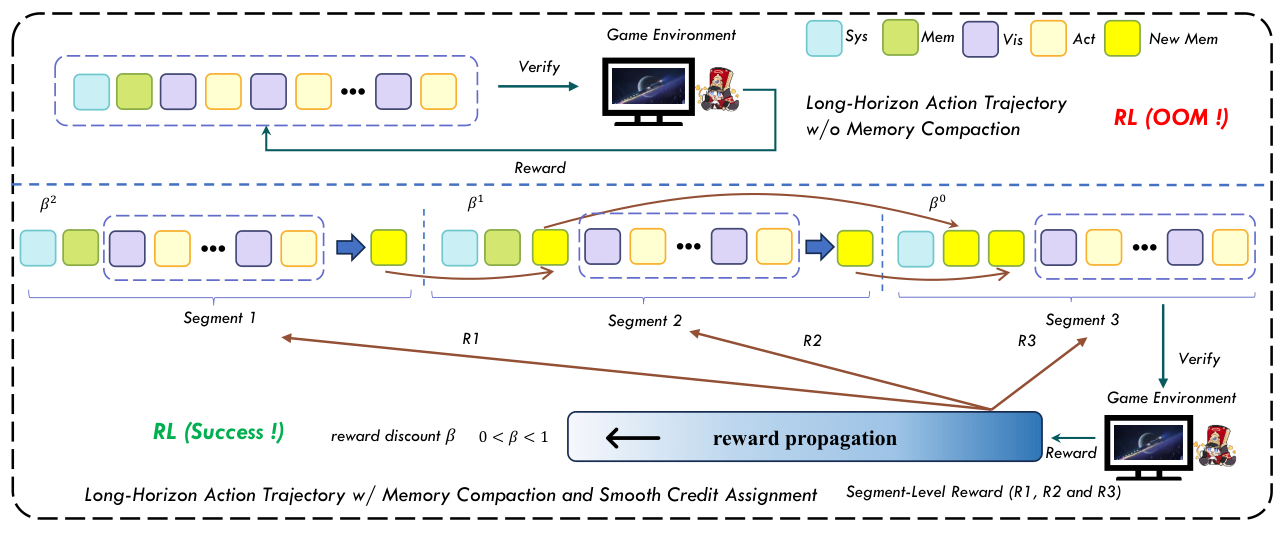
论文中的时间感知GRPO训练设计;推理系统用于支持持续交互。
理论控制率不等于所有游戏帧率
最终配置列出的步率为15.36Hz,92.16Hz则是由每步六个动作块换算出的理论控制率。它与论文实际游戏设置中的5Hz截图和30Hz键鼠控制属于不同口径,也不表示任意GPU、模型或并发量都能达到同样延迟。公开论文给出了系统机制和测试条件,尚不能据此假定标准vLLM安装后即可直接复现全部优化。
























