








在sql中优化高基数列的group by聚合效率,核心策略是避免全表扫描和内存溢出,优先利用索引覆盖(covering index)实现索引内聚合,或在数据量极大时采用分桶(bucketing)与物化视图进行预计算。具体做法包括为group by涉及的列建立复合索引以消除排序开销,对超大规模数据集使用近似聚合函数或采样分析,以及通过分区表将聚合范围缩小至局部数据块。
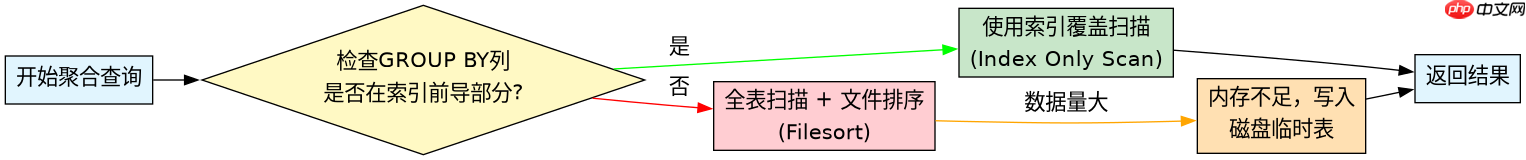
如何利用索引覆盖消除文件排序
当GROUP BY的列包含在索引的前导部分且查询仅涉及索引列时,数据库可直接从索引树中读取数据完成分组,无需回表查询数据行,也避免了昂贵的临时表排序操作。这种做法能显著降低I/O开销,将时间复杂度从O(N log N)降低至接近O(N)。关键在于确保索引覆盖了SELECT列表中的所有非聚合字段,从而形成“覆盖索引”。
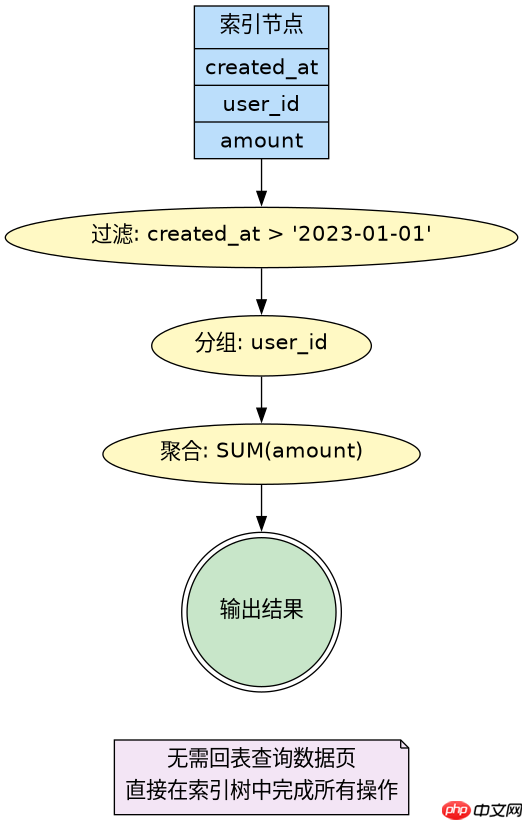
-- 假设表结构:orders (id, user_id, amount, created_at)
-- 错误做法:未建立合适索引,导致全表扫描+文件排序
SELECT user_id, SUM(amount)
FROM orders
WHERE created_at > '2023-01-01'
GROUP BY user_id;

-- 优化做法:建立复合索引,覆盖过滤条件和分组字段
CREATE INDEX idx_user_created_amount ON orders (created_at, user_id, amount);

-- 执行计划将显示 Using index (Index Only Scan)
SELECT user_id, SUM(amount)
FROM orders
WHERE created_at > '2023-01-01'
GROUP BY user_id;
上述代码中,索引`idx_user_created_amount`的顺序至关重要。`created_at`作为前导列用于快速定位满足WHERE条件的起始位置,`user_id`紧随其后用于直接分组,`amount`用于直接求和。这种结构使得MySQL或PostgreSQL等引擎可以在遍历索引的过程中直接完成过滤、分组和聚合,完全跳过数据页的访问。
如何处理超出内存容量的超大分组
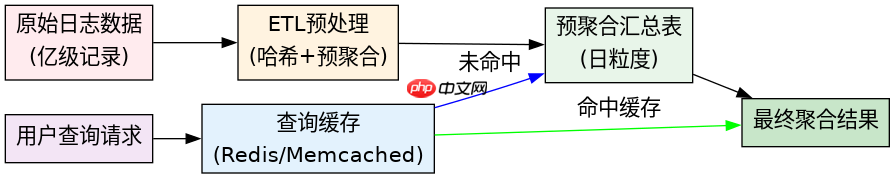
当分组后的中间结果集超过服务器内存限制(如MySQL的`sort_buffer_size`或PostgreSQL的`work_mem`)时,数据库会触发磁盘临时表交换,导致性能急剧下降。解决此问题的有效手段是使用近似算法或预先聚合的小粒度数据。例如,使用`APPROX_COUNT_DISTINCT`替代精确计数,或者在ETL阶段按天/周进行预聚合,生成汇总表供查询使用。
-- 场景:统计亿级日志数据的唯一IP数,精确值要求不高
-- 原始慢查询:需要将所有IP加载到内存去重
SELECT COUNT(DISTINCT ip_address) FROM access_logs;

-- 优化方案1:使用近似函数(PostgreSQL/ClickHouse支持)
SELECT APPROX_COUNT_DISTINCT(ip_address) FROM access_logs;

-- 优化方案2:预聚合表(Materialized View / Summary Table)
-- 创建每日聚合表
CREATE TABLE daily_ip_summary (
    log_date DATE,
    ip_hash VARCHAR(64), -- 存储IP的哈希值以减少空间
    count BIGINT,
    PRIMARY KEY (log_date, ip_hash)
);

-- 查询时直接汇总预聚合数据
SELECT SUM(count) FROM daily_ip_summary WHERE log_date = '2023-10-01';
在第二个示例中,通过将高基数的IP地址哈希化并预先按天聚合,我们将单次查询的数据量从亿级降低到万级甚至千级。虽然牺牲了极少量的精度(如果使用哈希碰撞可能影响唯一性,但在大数据量下概率极低),但换取了数量级的性能提升。对于必须精确的场景,建议结合分区表,将数据按时间分区后,仅在最近的热数据上进行实时聚合,冷数据则依赖预生成的汇总表。
高基数列聚合时的并行处理瓶颈
在高并发场景下,即使单个查询已优化,大量并发的GROUP BY请求仍可能耗尽连接池或CPU资源。此时应引入查询限流和结果缓存机制。例如,使用Redis缓存常见的分组键组合结果,或者在应用层对相同的聚合请求进行合并。此外,现代数据库(如MySQL 8.0+、PostgreSQL)支持并行查询(Parallel Query),可通过调整`max_parallel_workers`等参数,让多个CPU核心同时处理不同的数据分片,最后合并结果,从而线性提升吞吐量。


















