








使用 cube 或 rollup 子句配合 group by 可以一次性生成分组明细和聚合汇总。该操作会在标准分组结果的基础上,自动追加不同层级的合计行,无需编写多个查询语句或使用临时表拼接。
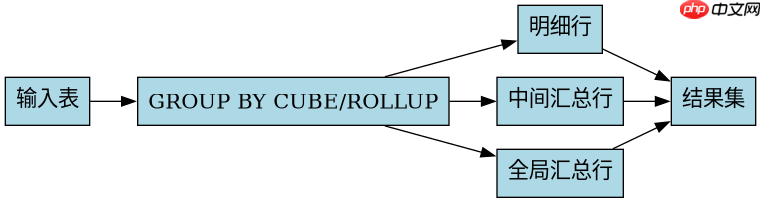
CUBE 如何生成所有维度的组合汇总
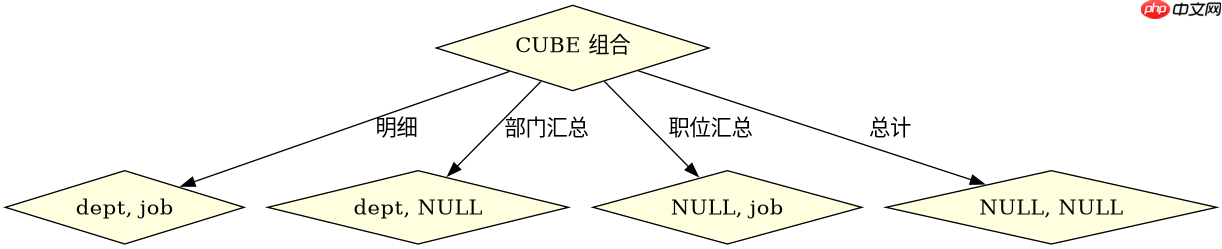
CUBE 会针对 GROUP BY 中指定的所有列,生成它们的所有可能组合的聚合结果。这意味着除了按每个维度单独分组的明细外,还会生成按任意两个维度、以及全表总计的行。这些汇总行的维度字段值为 NULL,用于标识该行是更高层级的统计结果。
SELECT
    department,
    job_title,
    SUM(salary) AS total_salary
FROM employees
GROUP BY CUBE (department, job_title);
上述查询在 employees 表上执行时,返回的结果集包含以下部分:首先是按 department 和 job_title 精确匹配的明细行;其次是按 department 汇总但 job_title 为空的行;接着是按 job_title 汇总但 department 为空的行;最后是两列均为 NULL 的全局总计行。这种结构允许前端报表工具直接通过判断字段是否为空来区分明细与汇总数据。
ROLLUP 如何实现层级递进汇总
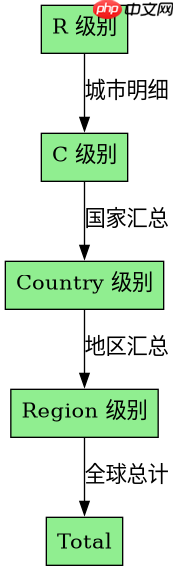
ROLLUP 按照 GROUP BY 列表中列定义的顺序,从右向左逐步忽略列进行聚合,形成层级式的汇总结构。它适用于具有明确父子层级关系的维度,例如先按部门再按职位,汇总时会先计算部门内各职位的明细,再计算部门总计,最后计算公司总计,不会生成跨维度的随机组合。
SELECT
    region,
    country,
    city,
    COUNT(id) AS user_count
FROM users
GROUP BY ROLLUP (region, country, city);
在用户分布统计场景中,上述查询首先输出按 region, country, city 三列完全匹配的明细;随后按 region 和 country 汇总,city 置空;接着按 region 汇总,country 和 city 均置空;最后是全区域总计。这种层级递进特性使得结果集天然适合展示树状结构的报表,且生成的行数通常少于 CUBE,在处理高基数维度时性能更优。
如何区分明细行与汇总行以进行后续处理
在获取到包含明细和汇总的混合结果集后,可以通过检查维度列是否为 NULL 来区分行类型。在实际业务逻辑中,通常希望保留明细行的原始值,而将汇总行的维度值替换为特定标识(如“总计”),以便在前端展示或导出时获得更友好的文本说明。
SELECT
    COALESCE(department, 'All Departments') AS dept_display,
    COALESCE(job_title, 'All Jobs') AS title_display,
    SUM(salary) AS total_salary
FROM employees
GROUP BY CUBE (department, job_title);
使用 COALESCE 函数可以将 CUBE 或 ROLLUP 产生的 NULL 值转换为可读字符串。例如,当 department 为 NULL 时,显示为 “All Departments”,这表示该行是该维度下的汇总值。这种方法避免了在应用层进行复杂的条件判断,直接在 SQL 层面完成了数据的清洗和格式化,确保返回给客户端的数据结构一致且易于解析。















