








在sql server 2019中,通过启用批处理模式执行(batch mode execution)可以显著提升存储过程在处理大规模数据时的速度。具体做法是确保查询涉及列存储索引或内存优化表,并设置数据库兼容级别为150以支持该特性。当查询能够利用向量化处理时,系统会自动采用批处理模式,从而减少cpu开销并提高吞吐量。

如何配置数据库以支持批处理模式
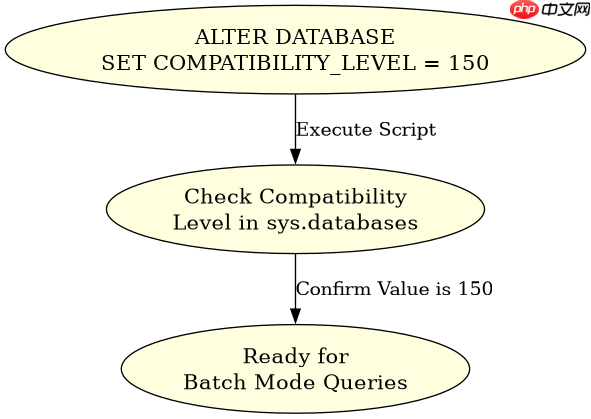
要使存储过程具备使用批处理模式的潜力,必须将数据库的兼容级别设置为150。这可以通过执行ALTER DATABASE命令来实现,确保服务器环境允许SQL Server 2019引入的新优化器行为。配置完成后,查询处理器才能识别并应用针对大规模扫描和聚合的批处理逻辑。
-- 假设当前数据库名为 SalesDB
ALTER DATABASE SalesDB SET COMPATIBILITY_LEVEL = 150;
执行上述语句后,数据库即进入兼容模式150。此时,任何后续创建的存储过程若包含符合批处理条件的查询,都将自动受益于新的执行计划生成机制。无需修改现有代码结构,仅需环境配置到位即可生效。
哪些类型的查询能触发批处理模式
并非所有查询都会使用批处理模式。只有当查询涉及列存储索引(Columnstore Index)且满足特定谓词条件时,才会激活向量化执行引擎。例如,对大型事实表进行GROUP BY聚合或简单过滤操作,如果数据量足够大且统计信息准确,优化器会选择批处理路径而非传统的行模式处理。

CREATE CLUSTERED COLUMNSTORE INDEX idx_cc_fact ON FactSales;
GO

-- 此查询可能触发批处理模式
SELECT ProductID, SUM(Amount)
FROM FactSales
WHERE SaleDate > '2023-01-01'
GROUP BY ProductID;
在上述示例中,由于FactSales表拥有聚集列存储索引,且查询包含聚合与过滤,SQL Server 2019的优化器会评估数据分布。若数据量大且谓词选择性适中,执行计划中将出现“批处理模式”标识。开发者可通过查看实际执行计划来验证是否成功启用。注意,小表或复杂嵌套子查询通常仍回退到行模式,因此需关注数据规模与索引类型。
批处理模式下存储过程的执行计划有何特征
在批处理模式中,存储过程内的查询节点会显示特定的运算符属性,如“Batch Size”和“Vectorization”。这些特征表明数据是以批次而非单行方式处理的。此外,内存占用模式也会变化,因为向量化引擎需要预分配缓冲区来容纳整个批次的数据。监控这些指标有助于确认性能提升来源。
-- 启用实际执行计划以观察批处理特征
SET STATISTICS PROFILE ON;
GO
EXEC dbo.usp_GetSalesSummary;
GO
SET STATISTICS PROFILE OFF;
运行上述代码后,结果集将包含XML执行计划片段。查找其中标记为“BatchMode”的操作符,例如“Batch Aggregate”或“Batch Hash Match”。这些操作符的存在证实了批处理模式已被应用。同时,注意比较CPU时间与I/O时间的比例,批处理模式通常能显著降低CPU利用率,尤其在聚合操作中。若未观察到这些特征,需检查索引是否存在、数据量是否不足或统计信息是否过时。




















