








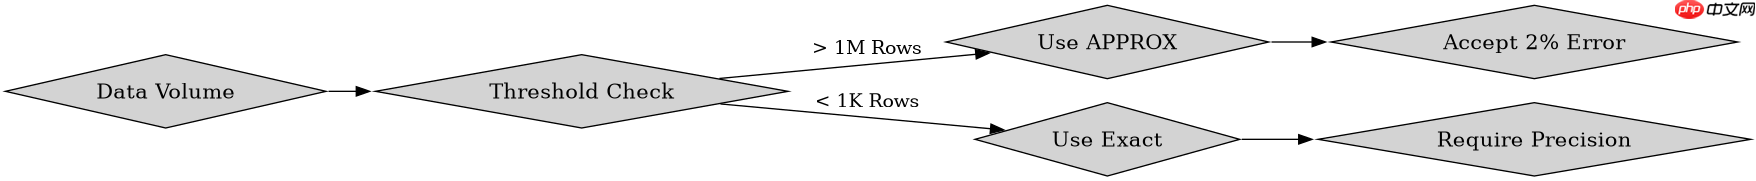
在 oracle 12c 及以上版本中,利用 approx_count_distinct 提速的核心做法是将其替换传统 sql 中的 count(distinct ...)。该函数基于 hyperloglog 算法,通过牺牲极小的精度(通常误差在 2% 以内)来换取显著的性能提升,特别适用于大数据量下的去重统计场景。
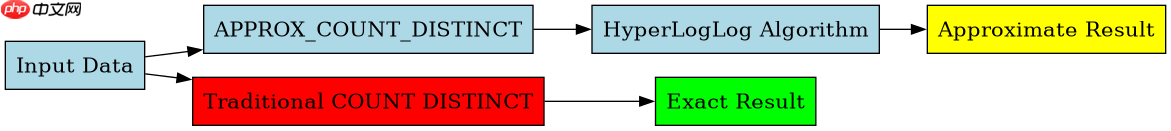
如何替换 COUNT DISTINCT 并验证性能差异?
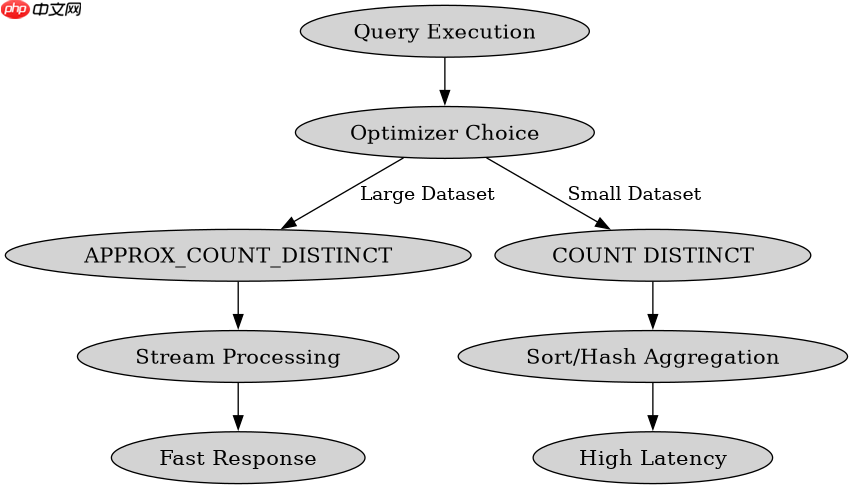
将查询语句中的 COUNT(DISTINCT column_name) 直接修改为 APPROX_COUNT_DISTINCT(column_name) 即可生效。Oracle 优化器会自动选择相应的执行计划,通常涉及哈希聚合或专门的近似计算算子。这种替换在处理亿级数据时,能将原本需要全表扫描和复杂排序/哈希的操作转化为更轻量级的流式处理,从而大幅缩短响应时间。
SELECT APPROX_COUNT_DISTINCT(employee_id) AS approx_distinct_count
FROM employees
WHERE department_id = 10;
预期结果:返回一个接近真实去重数量的数值,例如若真实值为 10000,可能返回 9850 至 10150 之间的值。执行时间远短于使用 COUNT(DISTINCT) 的查询。

在什么情况下应优先使用此函数?
当业务对精确度要求不高,且数据量极大导致传统 COUNT(DISTINCT) 成为性能瓶颈时,应优先使用 APPROX_COUNT_DISTINCT。它特别适合用于报表预览、实时大屏展示或初步的数据探索性分析。需要注意的是,如果数据基数很小(例如去重后少于几百条),由于算法本身的开销,其性能优势不明显,甚至可能略慢于精确计算,此时建议保持使用标准 COUNT(DISTINCT)。
-- 对比测试脚本
DECLARE
  v_start_time TIMESTAMP;
  v_end_time TIMESTAMP;
BEGIN
  -- 测试 APPROX_COUNT_DISTINCT
  v_start_time := SYSTIMESTAMP;
  FOR i IN 1..100 LOOP
    EXECUTE IMMEDIATE 'SELECT APPROX_COUNT_DISTINCT(object_id) FROM large_table';
  END LOOP;
  v_end_time := SYSTIMESTAMP;
  DBMS_OUTPUT.PUT_LINE('Approx Time: ' || (v_end_time - v_start_time));

  -- 测试 COUNT DISTINCT
  v_start_time := SYSTIMESTAMP;
  FOR i IN 1..100 LOOP
    EXECUTE IMMEDIATE 'SELECT COUNT(DISTINCT object_id) FROM large_table';
  END LOOP;
  v_end_time := SYSTIMESTAMP;
  DBMS_OUTPUT.PUT_LINE('Exact Time: ' || (v_end_time - v_start_time));
END;预期结果:Approx Time 显著小于 Exact Time,具体倍数取决于数据量和硬件配置,通常在 5 倍到 50 倍之间。
APPROX_COUNT_DISTINCT 的精度误差范围是多少?
根据 Oracle 官方文档,APPROX_COUNT_DISTINCT 的结果与真实值的偏差通常控制在 2% 以内。这意味着对于 1,000,000 个唯一值,返回结果可能在 980,000 到 1,020,000 之间。这种误差在大多数商业智能(BI)分析和日志统计场景中是可以接受的。开发者在使用时应确保下游应用能够容忍这种微小的不确定性,避免将其用于需要绝对精确的财务结算或库存扣减等关键业务逻辑中。



















