








sql查询优化器无法扁平化嵌套子查询,通常是因为语义上的依赖冲突或执行效率的权衡。当子查询引用了外部表的列(相关子查询)时,其执行逻辑必须保持嵌套以维持数据关联;若强行扁平化会导致笛卡尔积膨胀或重复计算。此外,对于包含聚合函数、去重(distinct)或集合操作(union/intersect)的子查询,扁平化会改变结果的基数和分组逻辑,因此优化器会保留其独立执行的结构。
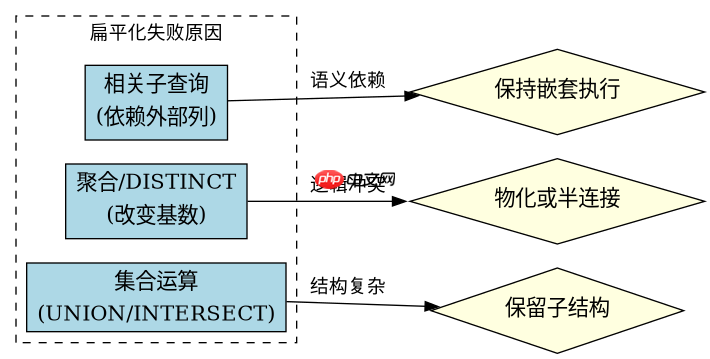
相关子查询为何不能直接合并
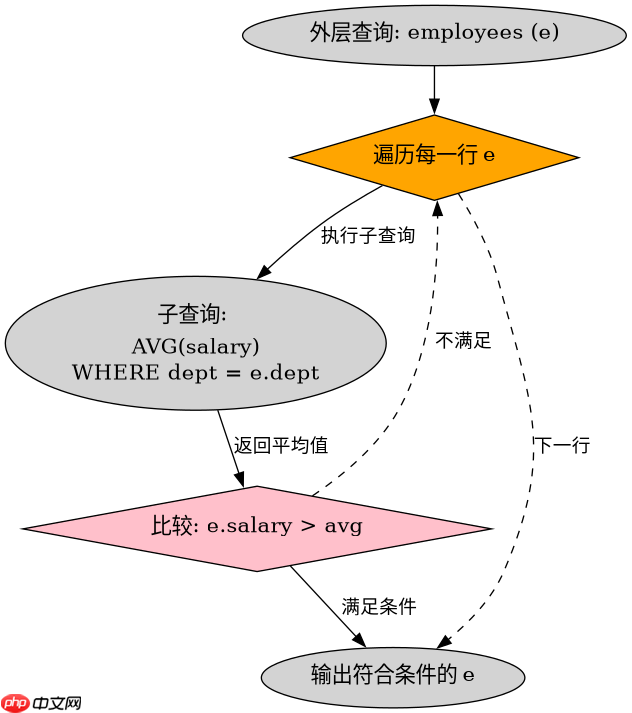
相关子查询无法扁平化的核心原因在于它依赖于外部查询的每一行数据作为输入条件。如果强行将这类子查询展开为普通的JOIN连接,会导致外层表与内层结果集产生大量的重复行,或者需要极其复杂的去重逻辑来还原原始语义。优化器为了保持查询的正确性,必须将相关子查询视为一个独立的执行单元,针对外层表的每一行(或每个分组)单独执行一次子查询逻辑。
SELECT e.name, e.salary
FROM employees e
WHERE e.salary > (
    SELECT AVG(salary)
    FROM employees
    WHERE department_id = e.department_id
);
预期结果:返回薪资高于其所在部门平均薪资的员工姓名和薪资。由于子查询中的 department_id = e.department_id 引用了外层的 e,该子查询必须对每个员工所在的部门分别计算平均值,无法通过简单的表连接一次性完成。
聚合与去重子查询的处理策略
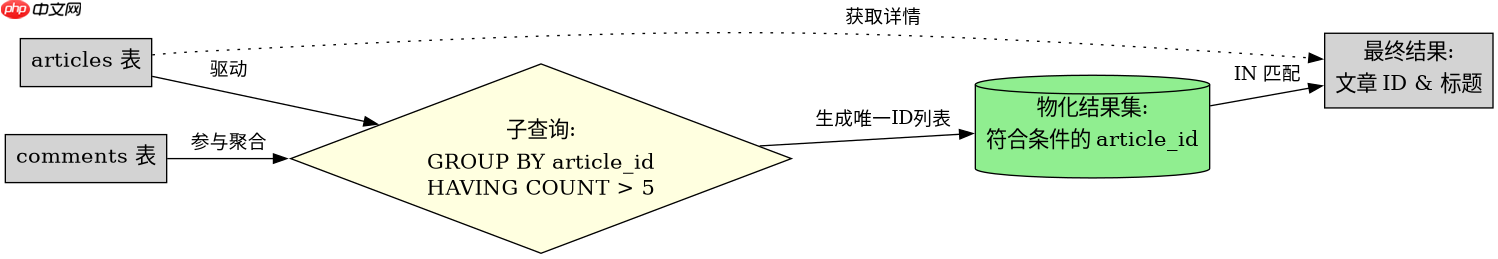
当子查询中包含 GROUP BY、DISTINCT 或集合运算符时,扁平化会破坏数据的唯一性或聚合粒度。例如,如果一个子查询用于过滤掉在另一张表中存在重复记录的行,直接将其转换为 JOIN 会产生重复的外层行,导致最终结果集行数错误。优化器在这种情况下通常会选择将子查询物化为临时表或使用半连接(Semi-Join)策略,而不是完全扁平化为标准的内连接。
SELECT id, title
FROM articles
WHERE id IN (
    SELECT article_id
    FROM comments
    GROUP BY article_id
    HAVING COUNT(*) > 5
);
预期结果:返回评论数超过5条的文章ID和标题。子查询先按文章ID分组并计数,只有满足条件的文章ID才会被返回。如果扁平化为 JOIN,外层文章表会与多条评论直接连接,导致同一篇文章出现多次,除非在外层再进行一次 DISTINCT 处理,但这增加了计算开销。
特定条件下优化器的物化决策
在处理上述复杂子查询时,优化器会根据统计信息决定是否“物化”子查询的结果。如果子查询的结果集很小且计算成本高,优化器可能会先执行子查询并将结果存入内存或临时磁盘结构中,然后再与外层表进行匹配。这种策略避免了为外层每一行重复执行昂贵的聚合或扫描操作,是处理非扁平化子查询的高效手段。

















