








sql标量子查询无法使用复合索引,是因为数据库优化器在评估标量子查询的执行计划时,通常将其视为一个独立的、不可合并的子任务,导致其内部的过滤条件无法与外层表的索引结构有效结合,进而退化为全表扫描或索引全扫描。要解决这个问题,需要将标量子查询改写为 `join` 连接查询,或者使用窗口函数,从而让优化器能够利用复合索引进行高效的范围查找和关联。
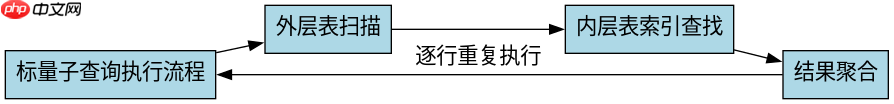
为什么标量子查询会导致索引失效
当你在 SELECT 列表中使用标量子查询时,例如 (SELECT name FROM users WHERE id = t.user_id),数据库通常会采用“相关子查询”的执行策略。这意味着对于外层查询的每一行结果,优化器都需要重新执行一次这个子查询。虽然子查询内部的 WHERE 条件可能命中了 users 表的复合索引(如 (id, status)),但关键在于执行频率和上下文隔离。如果外层查询返回大量数据,这种逐行执行的开销会急剧增加。更糟糕的是,在某些数据库引擎中,如果子查询的依赖关系复杂,优化器可能无法将子查询的谓词下推(Predicate Pushdown)到索引访问路径中,导致即使有复合索引,也只能通过主键或覆盖索引进行单点查找,而无法利用复合索引的前缀优势进行范围扫描或排序优化。此外,如果子查询涉及聚合或非确定性操作,索引的使用会被进一步限制。
CREATE TABLE orders (
    order_id INT PRIMARY KEY,
    user_id INT,
    amount DECIMAL(10, 2),
    INDEX idx_user_amount (user_id, amount)
);

CREATE TABLE users (
    user_id INT PRIMARY KEY,
    username VARCHAR(50),
    status TINYINT,
    INDEX idx_status_user (status, user_id)
);

-- 标量子查询写法:可能导致逐行执行,索引利用率低
SELECT
    o.order_id,
    o.amount,
    (SELECT u.username
     FROM users u
     WHERE u.user_id = o.user_id AND u.status = 1) AS username
FROM orders o;

-- 预期结果:orders 表全表扫描或索引扫描,对每一行执行一次 users 表的查找
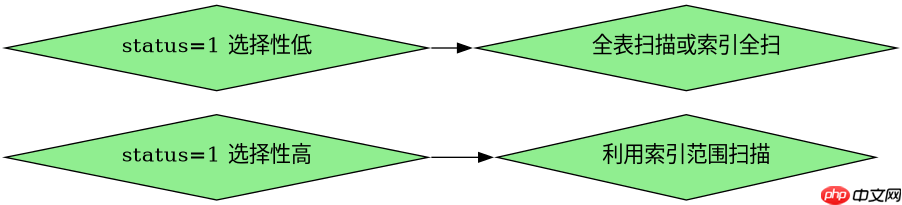
-- 如果 users 表很大,且 status 选择性不高,idx_status_user 可能无法有效加速所有行的查找
如何改写为JOIN以充分利用复合索引
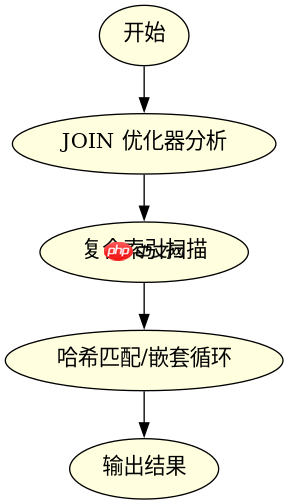
将标量子查询改写为 INNER JOIN 是解决此问题的标准做法。通过 JOIN,数据库优化器可以将两个表的访问路径合并,生成一个统一的执行计划。此时,优化器可以自由选择驱动表和被驱动表,并利用复合索引进行高效的哈希连接或嵌套循环连接。特别是在嵌套循环连接中,如果被驱动表使用了复合索引,数据库可以直接定位到满足条件的记录块,避免了重复的随机I/O。此外,JOIN 允许优化器进行更多的代价估算,从而选择最优的索引组合。例如,如果 users 表上有 (status, user_id) 的复合索引,JOIN 可以利用 status 进行范围过滤,再利用 user_id 进行精确匹配,这比单独的标量子查询更能发挥复合索引的威力。
-- 改写为 JOIN 写法:充分利用复合索引,优化器可生成更优执行计划
SELECT
    o.order_id,
    o.amount,
    u.username
FROM orders o
INNER JOIN users u ON o.user_id = u.user_id
WHERE u.status = 1;

-- 预期结果:优化器可能选择 users 表作为驱动表,利用 idx_status_user 快速筛选出 status=1 的用户
-- 然后通过 user_id 关联 orders 表,若 orders 也有相应索引,可进一步加速
-- 整体执行次数减少,I/O 效率显著提升
基于具体输入条件验证索引使用情况
为了验证上述结论,我们可以使用具体的输入数据进行测试。假设 users 表中有 10000 条记录,其中 status=1 的有 1000 条。在标量子查询模式下,如果外层 orders 表有 5000 条记录,那么子查询将被执行 5000 次。即使每次查找都命中索引,总 I/O 次数也高达 5000 次索引查找。而在 JOIN 模式下,优化器可以先利用 idx_status_user 一次性取出所有 status=1 的用户(1000 条),然后与 orders 表进行连接。如果 orders 表也建立了 user_id 索引,连接过程将更加高效。通过 EXPLAIN 命令对比两种写法的执行计划,可以清晰地看到 JOIN 写法中 type 字段为 ref 或 range,而标量子查询可能在某些情况下表现为 DEPENDENT SUBQUERY,表明其执行方式的不同。实际测试中,应确保统计信息最新,以便优化器做出准确决策。


















