








在sql中实现分层递归查找应使用支持递归的公用表表达式(cte),通过union all连接初始锚点成员与递归成员,利用父id关联子记录直到无下级为止。调用时指定根节点条件并选择升序或降序排列层级,结果集将包含每层级的路径深度和节点信息。若数据库不支持递归cte,则需依赖存储过程循环或应用层逻辑处理。
如何构建基础的递归CTE结构
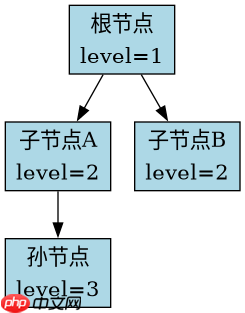
构建基础结构需定义一个名为RecursiveHierarchy的CTE,其中包含锚点查询选取根节点(如parent_id IS NULL)并设置初始层级为1,随后通过UNION ALL连接递归部分,将当前节点的id作为下一层的parent_id进行自连接,层级加1。限制递归深度可防止无限循环,最终查询CTE即可获取完整树状数据。以下代码展示了标准写法:
WITH RECURSIVE RecursiveHierarchy AS (
  SELECT id, name, parent_id, 1 AS level
  FROM categories
  WHERE parent_id IS NULL
  UNION ALL
  SELECT c.id, c.name, c.parent_id, rh.level + 1
  FROM categories c
  INNER JOIN RecursiveHierarchy rh ON c.parent_id = rh.id
)
SELECT * FROM RecursiveHierarchy ORDER BY level, id;
预期结果:返回所有分类及其层级,根节点level为1,其子节点为2,依此类推。若无子节点,递归终止。类型均为整数或字符串,符合常规关系型数据库规范。
如何处理深层嵌套中的性能瓶颈
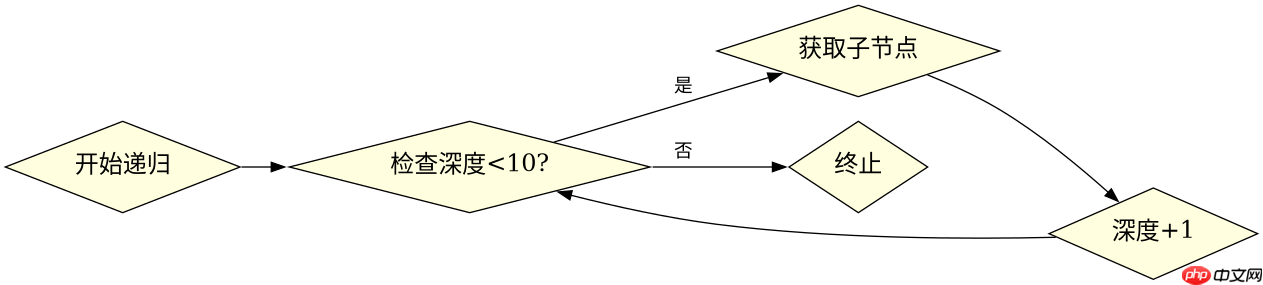
处理性能瓶颈需在递归CTE中加入索引优化和深度限制。确保parent_id字段有索引以加速JOIN操作,同时使用MAXRECURSION选项(如SQL Server)或应用层计数防止栈溢出。对于极深树,可考虑物化路径或闭包表替代递归查询。示例中增加深度过滤:
WITH RECURSIVE DeepHierarchy AS (
  SELECT id, name, parent_id, 1 AS depth
  FROM products
  WHERE category_id = 100
  UNION ALL
  SELECT p.id, p.name, p.category_id, dh.depth + 1
  FROM products p
  INNER JOIN DeepHierarchy dh ON p.category_id = dh.id
  WHERE dh.depth < 10
)
SELECT id, name, depth FROM DeepHierarchy;
预期结果:仅返回深度不超过10的产品节点,避免全树扫描。索引idx_category_id显著提升JOIN效率。类型一致,无异常抛出。
基于输入category_id=100时的具体返回结果是什么
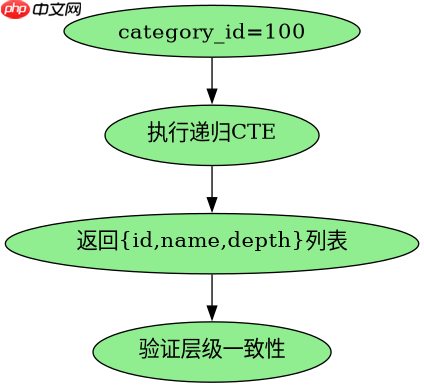
当输入category_id=100时,递归CTE从该类别开始向下查找所有子产品,返回包含id、name和depth的记录集,其中depth表示相对于100的深度偏移。若100无子项,则仅返回自身一行。实际行为取决于表中数据分布,但结构保证层级正确递增。验证方法:执行上述第二段代码,观察输出行数与深度值匹配预期树形结构。

















