








在vs code中比较copilot fusion、judge和synthesizer的配置,核心在于理解它们各自的角色:fusion是负责合并多个模型结果的协调器,judge是用于评估代码质量的裁判,而synthesizer是实际生成代码的引擎。要有效比较它们,你需要分别查看各自的配置文件(如`settings.json`中的特定键),并观察它们在处理同一输入时的行为差异,例如fusion如何决定最终输出,judge如何打分,以及synthesizer生成的代码是否符合预期。
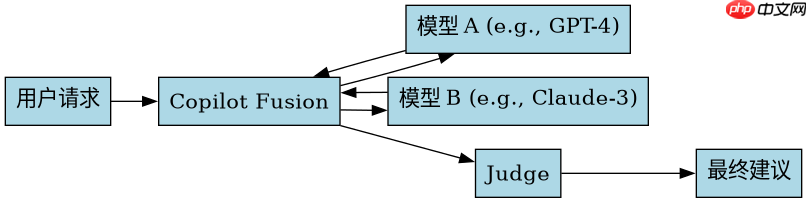
Copilot Fusion如何合并多个模型结果
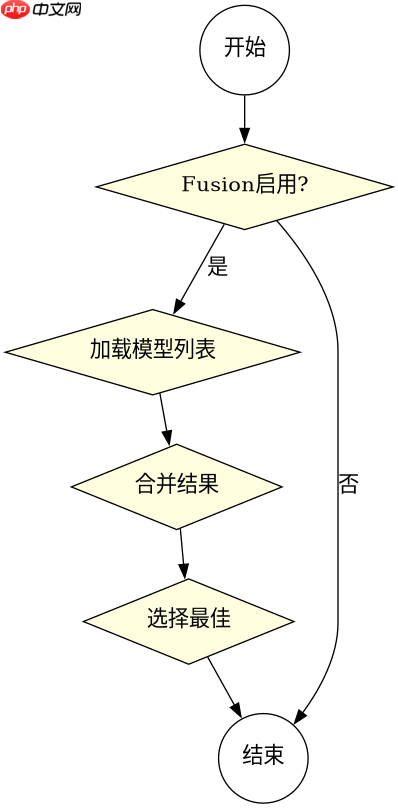
Fusion通过配置`github.copilot.fusion.enabled`开启,并使用`github.copilot.fusion.models`指定参与融合的模型列表。它会根据权重和策略(如多数投票或最佳选择)合并来自不同模型的补全建议。若未启用,则仅使用默认模型。
{
  "github.copilot.fusion.enabled": true,
  "github.copilot.fusion.models": ["gpt-4", "claude-3"],
  "github.copilot.fusion.strategy": "best"
}
上述配置启用了Fusion,并指定了GPT-4和Claude-3作为候选模型,策略为“best”,即选择评分最高的结果。运行后,VS Code会显示融合后的单一建议,而非多个独立建议。
Judge如何评估代码质量
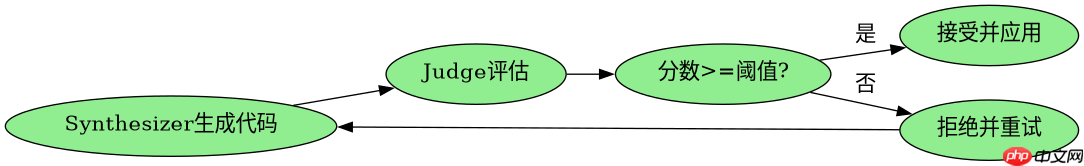
Judge通过`github.copilot.judge.enabled`启用,并使用`github.copilot.judge.threshold`设置最低接受分数。它会对Synthesizer生成的代码进行静态分析和语义检查,若分数低于阈值,则拒绝该建议并提示重新生成。若禁用,则跳过评估直接应用。

{
  "github.copilot.judge.enabled": true,
  "github.copilot.judge.threshold": 0.8
}
此配置启用了Judge,并设定阈值为0.8。当Synthesizer生成代码后,Judge会计算其质量分数,若低于0.8,用户将收到“代码质量不足”的提示,需手动调整或重新触发生成。
Synthesizer在不同输入条件下的行为差异
Synthesizer的行为受`github.copilot.editor.autoCompletions.enabled`控制,且其输出依赖于上下文窗口大小和语言模型的选择。在简单表达式中,它可能快速返回单行补全;在复杂逻辑块中,它可能生成多行代码并附带注释。若上下文缺失关键信息,它可能返回空值或通用模板。
// 示例输入
function calculate(a, b) {
  return a + b;
}

// Synthesizer输出
function calculate(a, b) {
  if (typeof a !== 'number' || typeof b !== 'number') {
    throw new TypeError('Arguments must be numbers');
  }
  return a + b;
}
在上述示例中,Synthesizer不仅完成了函数体,还添加了类型检查,这是因为它检测到参数类型未明确声明,从而推断出需要增强健壮性。若输入已包含类型注解,则输出会更简洁。
















