








qwen4-max显式缓存需要至少1024个token的可复用前缀。把长文放入内容块并设置prompt_cache_breakpoint,后续请求保持前缀完全一致、只改变断点之后的问题,再根据usage中的缓存写入与命中字段判断结果。缓存写入、读取和普通输入分别计价,不能只看读取单价就计算全部成本。
准备足够长、允许提交给接口的资料
使用同一地区、同一账号的按量API及对应DASHSCOPE_API_KEY,安装OpenAI Python SDK。将允许上传的公开长文保存为reference.txt;至少1024 Token指模型分词后的数量,不是1024个字节或字符。不要为试验上传无授权的私人资料。
python -m pip install openai
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
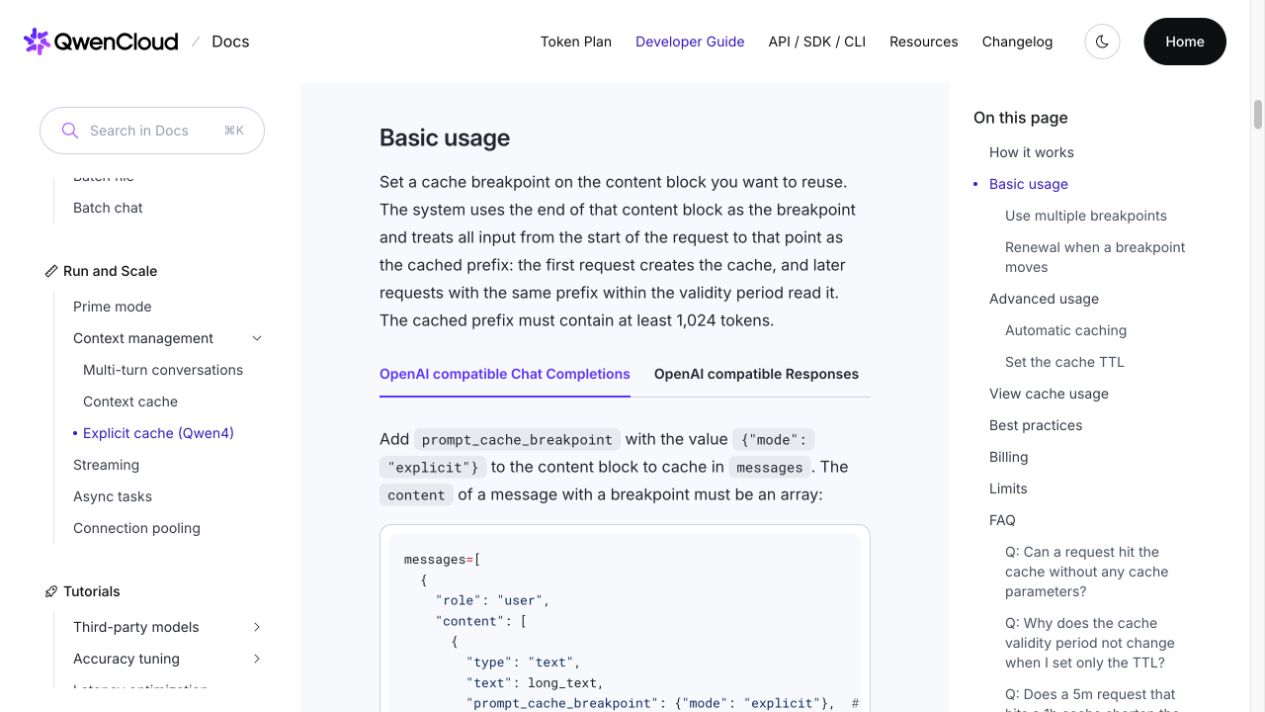
官方显式断点配置说明
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",
)
reference = Path("reference.txt").read_text(encoding="utf-8")

for question in ["列出文档的三个主要结论。", "指出第二个结论适用的条件。"]:
    result = client.chat.completions.create(
        model="qwen4-max",
        messages=[{"role": "user", "content": [
            {"type": "text", "text": reference,
             "prompt_cache_breakpoint": {"mode": "explicit"}},
            {"type": "text", "text": question},
        ]}],
        max_completion_tokens=512,
        extra_body={"enable_thinking": False,
                    "prompt_cache_options": {"mode": "explicit", "ttl": "5m"}},
    )
    print(result.choices[0].message.content)
    print(result.usage.model_dump() if result.usage else None)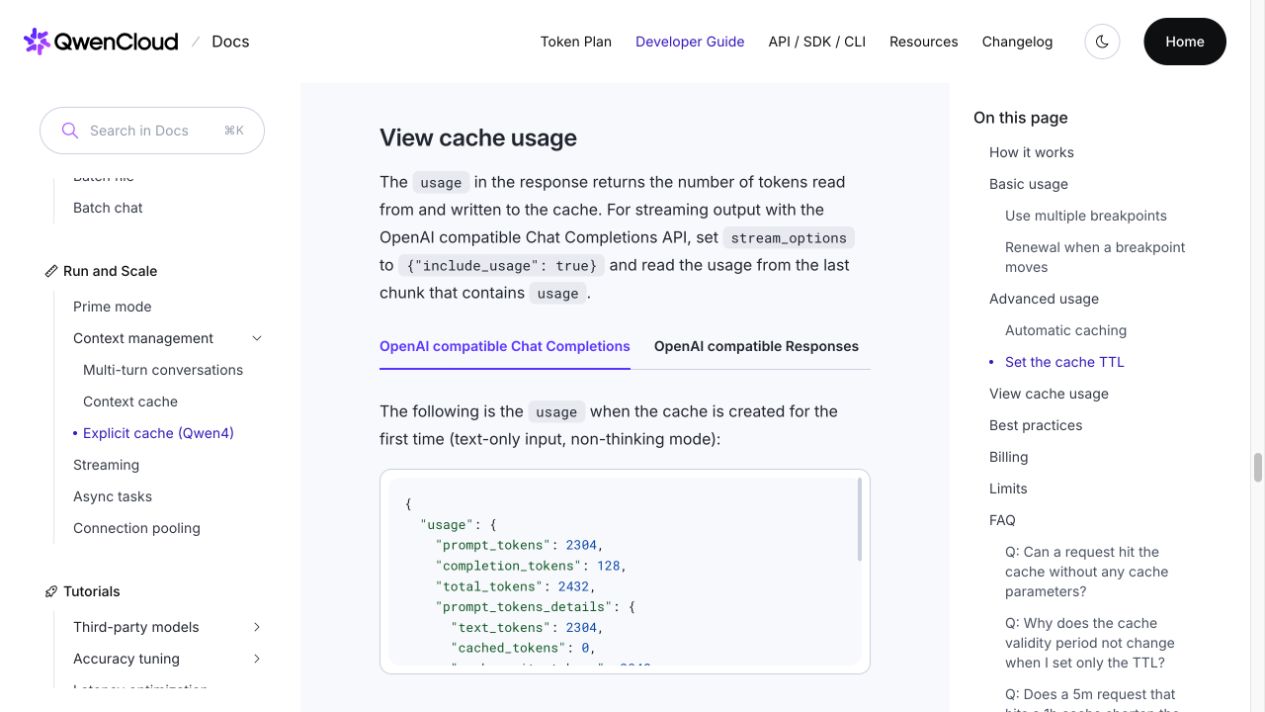
官方缓存usage响应示例,非本次调用结果
以返回用量判断,不预设第二次一定命中
保存为cache_demo.py并运行。先核对第一次是否产生cache_write_tokens,再检查后续prompt_tokens_details.cached_tokens等返回字段。不要把示例运行两次就写成已经获得固定比例的节省;前缀过短、内容变化、过期或账号范围不一致都可能影响匹配。

默认有效期为5分钟,也可按业务选择1小时。需要复用的system、工具定义和资料等前缀应保持顺序与内容一致;会变化的问题放在断点之后。显式断点和旧cache_control标记不要混用,且不要把仅填写ttl等同于已经启用手动断点模式。
比较方案时把首次缓存写入、后续读取、未命中输入与输出一起统计。该示例针对Chat Completions;Qwen4的新显式缓存目前不适用于DashScope,不能只改端点就假定请求仍有相同缓存行为。






















