阿里千问大模型于11月16日正式推出 qwen4-max,定位为全天候 ai 协作伙伴。该模型基于全新升级的 qwen4 架构,总参数量达 2.4t,每 token 激活参数为 71b;此外还集成 328b 的 n-gram embedding 参数,原生支持视觉理解能力,并兼容百万级 token 上下文长度。
目前,Qwen4-Max 已在千问 AI 平台上线并开放 API 接入服务,缓存命中场景下每百万 Tokens 成本低至 0.5 元;用户亦可通过阿里 Token Plan 进行调用,或在千问办公、Qoder 等终端应用中直接体验;官方同步大幅下调 API 定价策略,Qwen4 系列中的中小规模模型也将分阶段开源。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
在架构设计层面,Qwen4-Max 聚焦注意力机制、残差连接与嵌入表示三大核心模块,全面优化稀疏 MoE 结构:每四层中,三层采用 Gated DeltaNet 压缩历史状态信息,一层引入块级上下文选择机制 QSA;Gated Residual 扩展为四路并行分支;N-gram Embedding 则以极低计算开销实现容量跃升。在 2.4T 参数规模下,预训练过程全程稳定,未出现任何损失尖峰;内部基准测试显示,其基座模型在知识、代码、问答及 STEM 四大类任务中的 BPB(Bits Per Byte)指标均为五个参评模型中最低,相较上一代同规模模型下降约 5–13%,单 token 激活参数量减少约 25%。
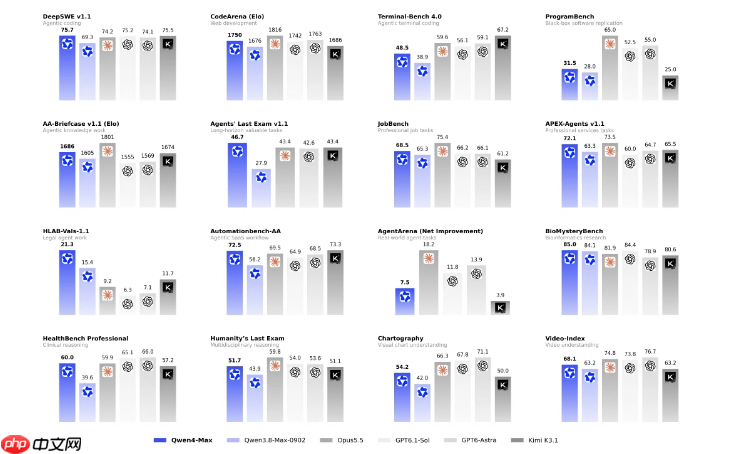

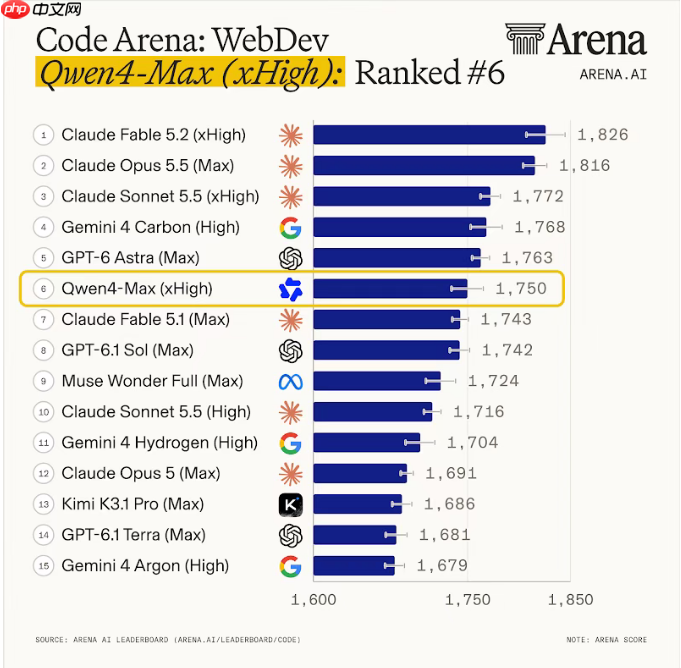
就性能与成本表现而言,Qwen4-Max 在 Code Arena 前端盲测中位居全球前列;在 Work360 行业基准测试中取得 52.69 分,超越 Qwen3.8-Max 的 47.74 分;在 Work360 与 Terminal-Bench4.0 测试中,Xhigh 和 High 两档 token 消耗分别降低约 24%、35% 与 48%、49%,单任务平均调用费用由 26.58 元降至 11.16 元,降幅达 58%。
在实际落地场景中,该模型展现出显著提效价值:汽车制造领域单个工件加工编程所需人工时间由约 475 分钟压缩至 24 分钟,效率提升约 95%;法律尽职调查可自动生成 86 页、超 6 万字的专业报告;药物发现任务中优选分子的结合亲和力达初始值的约 3.6 倍。
官方表示,Qwen4-Max 是 Qwen4 系列的首发旗舰模型,后续将陆续发布并开源多个轻量化版本。通过底层架构革新同步实现 token 利用率提升与 API 使用成本下降,进一步印证了当前大模型竞争正从单纯比拼参数规模,转向聚焦真实业务场景下的生产力交付能力。