








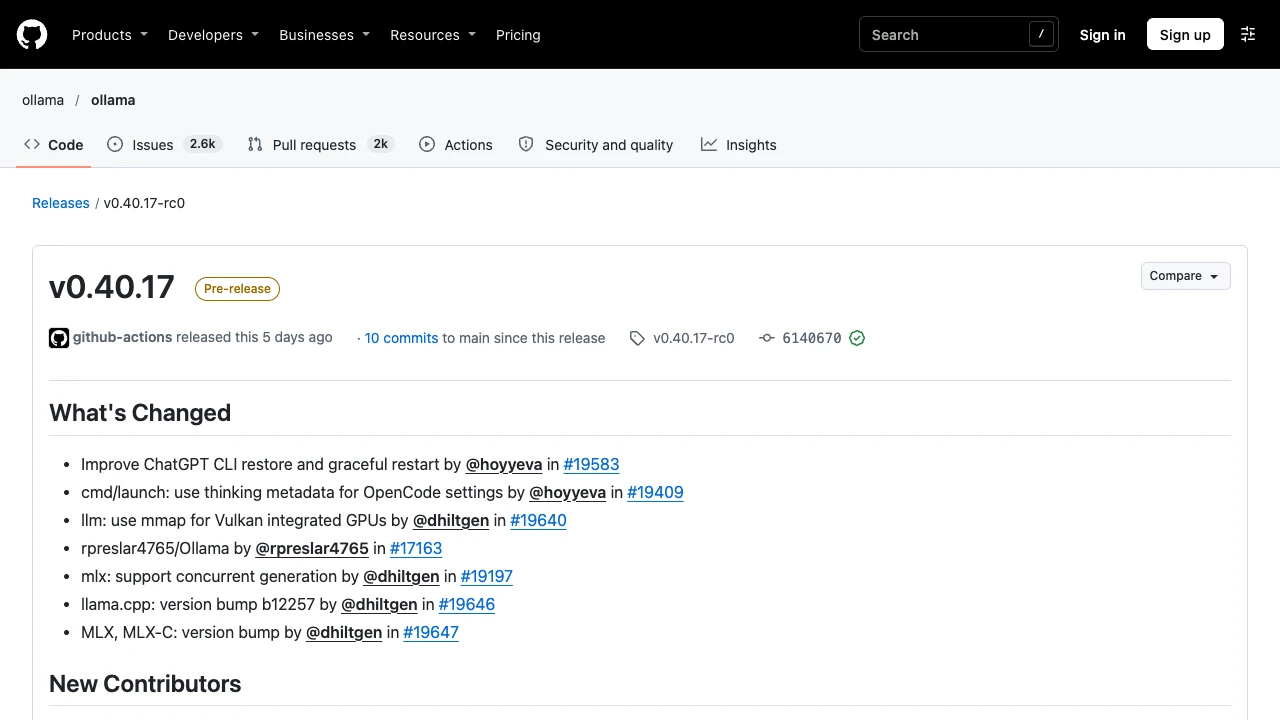
ollama v0.40.17-rc0是一条预发布记录,不能因为页面标题写着v0.40.17就当成稳定版。这次更新涉及mlx并发生成、vulkan集成显卡内存映射、底层组件和cli集成。评估时应先区分候选渠道,再看自己的硬件后端与工具是否落在对应范围,不能把一项后端改进概括为所有设备都获得同样提速。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
版本标题与完整标签为什么要一起看
该发布于北京时间2026年11月11日06:25提供,完整标签为v0.40.17-rc0,GitHub明确标为Pre-release。页面展示名称可以省略候选后缀,实际识别与依赖记录仍应保留rc0,不能把它写成0.40.17稳定版已经正式交付。
同理,后续是否有其他候选或稳定版本,是另一条版本记录。复核历史问题时需要对应完整标签和发布时间,不能仅凭主版本数字相近就推断安装内容相同,也不能要求已经使用后续受支持版本的环境直接降级。
MLX并发生成对评估范围有什么影响
发布说明加入MLX并发生成支持,并更新MLX与MLX-C组件。它针对相关后端的生成处理,不等于所有GPU、所有模型或所有并发负载都有同样表现。新增并发能力也不能直接变成统一的吞吐提升比例。
对照实际部署时,模型、后端与并发请求组合决定结果是否可比。能处理多个请求与每个请求的延迟、资源占用符合预期,是不同结果;版本说明没有给出可照搬到任意设备的容量承诺。

Vulkan内存映射修复不等于所有显卡内存策略变化
这一条变化明确限定Vulkan集成显卡路径使用mmap,也就是内存映射。它不是面向所有独立显卡或其他硬件后端的统一改动,不能仅看到“Vulkan”就推断任意图形设备和模型组合都受到相同影响。
如果环境不使用这条后端路径,就不能把该项列为已经解决自身问题的依据。是否命中适用范围与实际负载表现应分开判断,公告本身没有证明某台设备上的内存不足或性能问题必然消失。
llama.cpp组件版本与Ollama应用版本是两层信息
此次将llama.cpp组件更新到b12257,同时调整MLX、MLX-C。b12257是底层组件的版本标识,v0.40.17-rc0才是这条Ollama发布标签。二者应同时准确记录,不能把组件号当作Ollama版本,也不能据此编造一个通用的独立组件升级步骤。
OpenCode与ChatGPT CLI改进分别覆盖什么
OpenCode启动设置会使用thinking元数据;ChatGPT CLI则改进会话恢复与平滑重启。这些是相应集成路径的行为调整,不等于模型推理质量统一提升,也不是整个ChatGPT产品或所有命令行工具的共同更新。
采用候选版时,后端、模型与外部工具组合应有各自验收结果。应用能启动不证明并发负载已经通过,会话恢复不证明所有业务状态都被正确保留。该记录说明候选版包含哪些变化,没有提供适用于全部部署的性能或兼容保证。






















