








为什么一致性哈希不能直接用取余
因为取余算法在节点增减时会导致大量数据发生迁移,而一致性哈希通过虚拟节点和环形空间设计,将数据迁移量降低到最小。直接对节点数取余(如 hash(key) % n)无法实现这种平滑过渡。
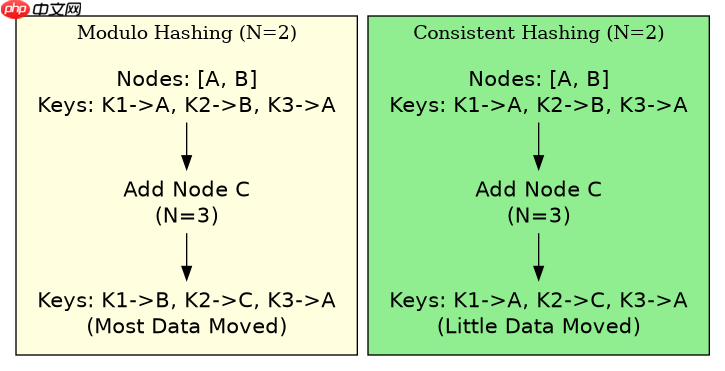
取余算法与一致性哈希的迁移对比
当节点数量发生变化时,取余算法会重新计算所有数据的归属,导致绝大部分数据需要移动;而一致性哈希只影响相邻节点的数据,实现了局部调整。
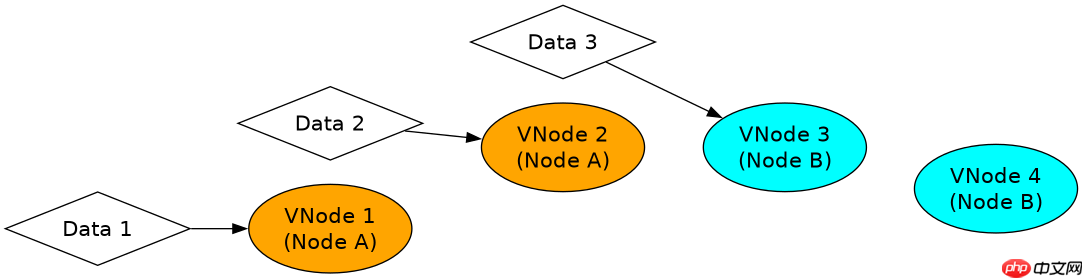
虚拟节点如何解决数据倾斜问题
单个物理节点在哈希环上只有一个点,容易导致数据分布不均。引入虚拟节点后,每个物理节点对应环上的多个点,从而均匀分散数据负载。
import hashlib

def get_hash(node_name):
    # 使用MD5生成哈希值并转为整数
    md5 = hashlib.md5(node_name.encode('utf-8')).hexdigest()
    return int(md5, 16)

def consistent_hashing(key, nodes, virtual_nodes=100):
    ring = []
    # 构建虚拟节点环
    for node in nodes:
        for i in range(virtual_nodes):
            v_node = f"{node}-v{i}"
            h = get_hash(v_node)
            ring.append((h, node))
    ring.sort(key=lambda x: x[0])

    key_hash = get_hash(key)
    # 查找第一个大于等于key_hash的节点
    for h, node in ring:
        if h >= key_hash:
            return node
    # 如果超过最大哈希值,绕回第一个节点
    return ring[0][1]

# 测试:初始节点
nodes = ['A', 'B']
print(f"Key 'data1' -> {consistent_hashing('data1', nodes)}")

# 新增节点C
nodes.append('C')
print(f"Key 'data1' after adding C -> {consistent_hashing('data1', nodes)}") 






















