








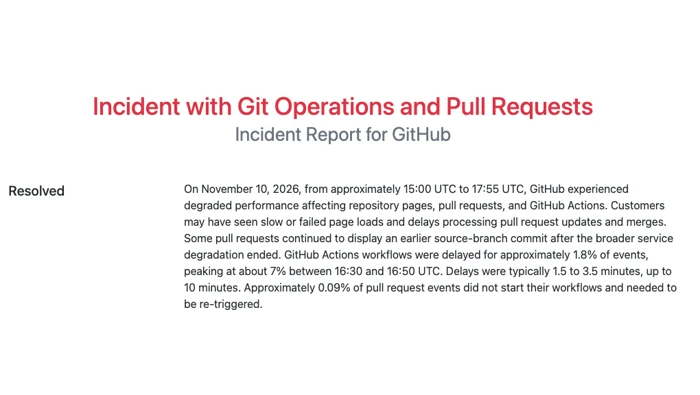
github服务恢复后,actions仍可能存在未启动的工作流。11月10日事故复盘区分了延迟与漏触发:约1.8%的事件出现工作流延迟,而约0.09%的拉取请求事件没有启动工作流,需要重新触发。两个比例的统计范围不同,不能把它们相加,也不能把状态页恢复理解为每个pr的检查都已完成。
等待中的运行与没有启动的运行有什么不同
延迟意味着事件对应的工作流处理受阻,后来可能继续推进;未启动则不能仅靠等待已有运行结束来解决。官方给出的延迟通常为1.5至3.5分钟,最长约10分钟,16:30至16:50 UTC期间延迟比例峰值约7%。这些是事故总体观察,不能作为单个仓库必然等待多久的保证。
约0.09%的分母明确是拉取请求事件,不是所有工作流运行、仓库或用户。官方没有公布受影响仓库清单,也没有说每个失败检查都属于这次漏触发。应用这一结论时,需要保留事件类型与具体检查结果的对应关系。
为什么整体恢复后PR还可能显示旧提交
本次性能下降发生在11月10日约15:00至17:55 UTC,影响仓库页面、拉取请求及Actions。用户可能遇到页面慢或加载失败,PR更新和合并处理延迟。总体服务下降结束后,部分PR仍显示源分支较早的提交,后台处理也继续追赶积压。
因此,页面可以打开、状态页转为恢复、PR同步到新提交、工作流实际启动,是不同层次的结果。单凭其中一个信号不能证明其他结果也成立。复盘并未将残留旧提交等同于源分支数据丢失,也没有宣称所有积压立即归零。

共享Git基础设施如何影响Actions
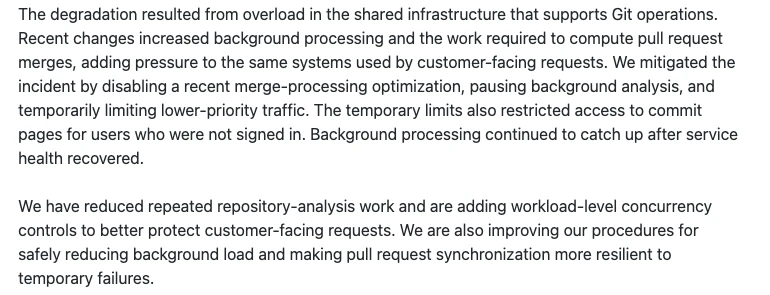
根因是支撑Git操作的共享基础设施过载。近期变更增加了后台处理和PR合并计算所需工作,与面向用户的请求争用同一系统。Actions的触发链依赖相关事件处理,所以故障影响会延伸到工作流启动,而不仅是网页响应速度。
GitHub通过关闭近期的合并处理优化、暂停后台分析、临时限制低优先级流量来缓解。临时限制还影响了未登录用户访问提交页面。它解释了事故期间某些访问差异,但不是当前要求用户退出或登录来修复仓库的操作指南。
重新触发仍要区分具体运行状态
复盘对漏触发事件明确提出重新触发需求,却没有提供一条适用于所有仓库的批量补跑命令。已经存在的运行与完全没有创建运行记录的事件,不具有相同的处理入口;存在运行记录也不表示应该无条件重复执行部署等有副作用的任务。
GitHub后续减少重复仓库分析工作,并增加工作负载级并发控制,同时改进安全降低后台负载及PR同步抵御临时故障的能力。这些措施针对共享资源竞争和恢复韧性,不能推导出未来所有触发都绝不延迟。





















