








java 的 longsupplier 本身不直接生成分布式 id,它只是一个提供 long 类型值的函数式接口。要实现分布式 id,通常结合雪花算法(snowflake)或 uuid 等逻辑,将生成的 id 封装在实现类中,并通过 lambda 表达式或方法引用传递给需要该接口的地方。

如何定义并实例化 LongSupplier 以返回雪花算法 ID
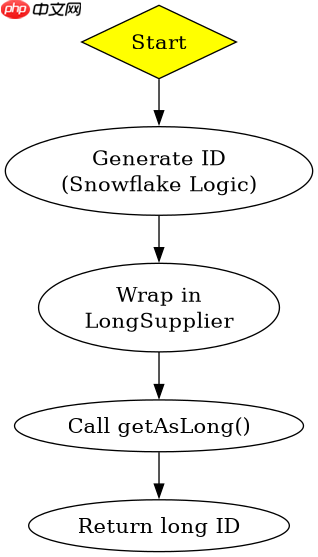
要使用 LongSupplier 获取分布式 ID,首先需要有一个生成 ID 的核心逻辑类,例如封装了雪花算法的 SnowflakeIdGenerator。该类必须提供一个符合 getAsLong() 签名的方法。接着,通过 Lambda 表达式 (() -> generator.getAsLong()) 或方法引用 generator::getAsLong 创建 LongSupplier 实例。这样,任何接收 LongSupplier 作为参数的方法都可以调用 getAsLong() 来获取唯一的长整型 ID。
public class SnowflakeIdGenerator {
    private long workerId;
    private long sequence = 0L;
    private long lastTimestamp = -1L;

    public SnowflakeIdGenerator(long workerId) {
        this.workerId = workerId;
    }

    public synchronized long nextId() {
        long timestamp = System.currentTimeMillis();
        if (timestamp < lastTimestamp) {
            throw new RuntimeException("Clock moved backwards");
        }
        if (timestamp == lastTimestamp) {
            sequence = (sequence + 1) & 4095;
            if (sequence == 0) {
                timestamp = waitNextMillis(timestamp);
            }
        } else {
            sequence = 0L;
        }
        lastTimestamp = timestamp;
        return ((timestamp - 1288834974657L) << 22)
                | (workerId << 12)
                | sequence;
    }

    private long waitNextMillis(long lastTimestamp) {
        long timestamp = System.currentTimeMillis();
        while (timestamp <= lastTimestamp) {
            timestamp = System.currentTimeMillis();
        }
        return timestamp;
    }
}

public class Main {
    public static void main(String[] args) {
        SnowflakeIdGenerator generator = new SnowflakeIdGenerator(1);
        // 使用 Lambda 创建 LongSupplier
        LongSupplier idSupplier = () -> generator.nextId();

        // 模拟多次获取 ID
        for (int i = 0; i < 5; i++) {
            System.out.println(idSupplier.getAsLong());
        }
    }
}
上述代码展示了完整的实现流程。SnowflakeIdGenerator 处理了时间戳回拨、序列号溢出等边界情况。主程序中,通过 Lambda 将 nextId 方法绑定到 LongSupplier。每次调用 idSupplier.getAsLong() 都会触发底层算法生成一个新的唯一 ID。这种解耦方式使得 ID 生成逻辑可以独立测试和替换。
立即学习“Java免费学习笔记(深入)”;

如何在多线程环境下安全地共享 LongSupplier
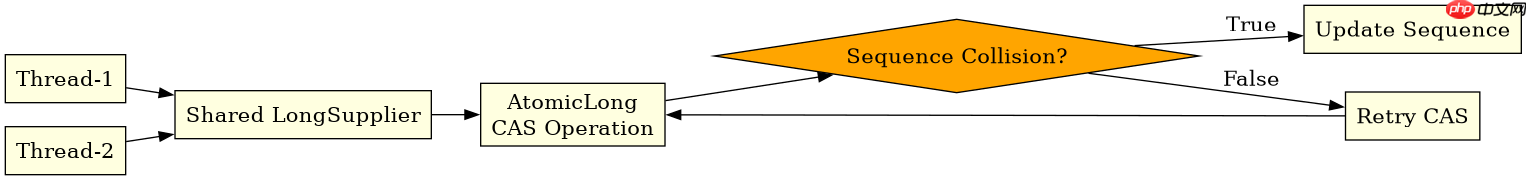
在多线程环境中,如果多个线程共享同一个 LongSupplier 实例,必须确保底层的 ID 生成逻辑是线程安全的。雪花算法中的 synchronized 关键字保证了同一时刻只有一个线程能修改状态。另一种更高效的方案是使用 AtomicLong 来管理序列号,或者为每个线程分配独立的 Worker ID 和序列号范围。如果 LongSupplier 被缓存并在高并发下使用,建议检查其内部实现是否使用了锁或原子操作,以避免性能瓶颈或数据竞争。
import java.util.concurrent.atomic.AtomicLong;

public class ThreadSafeIdGenerator {
    private final AtomicLong sequence = new AtomicLong(0);
    private final long workerId;

    public ThreadSafeIdGenerator(long workerId) {
        this.workerId = workerId;
    }

    public long nextId() {
        long currentSeq;
        long newSeq;
        do {
            currentSeq = sequence.get();
            newSeq = (currentSeq + 1) & 4095;
        } while (!sequence.compareAndSet(currentSeq, newSeq));

        long timestamp = System.currentTimeMillis();
        // 简化版:实际需处理时间回拨
        return ((timestamp << 22) | (workerId << 12) | newSeq);
    }
}

public class MultiThreadTest {
    public static void main(String[] args) throws InterruptedException {
        ThreadSafeIdGenerator generator = new ThreadSafeIdGenerator(1);
        LongSupplier supplier = generator::nextId;

        Runnable task = () -> {
            for (int i = 0; i < 100; i++) {
                System.out.println(Thread.currentThread().getName() + ": " + supplier.getAsLong());
            }
        };

        Thread t1 = new Thread(task, "Thread-1");
        Thread t2 = new Thread(task, "Thread-2");
        t1.start();
        t2.start();
        t1.join();
        t2.join();
    }
}
这段代码演示了基于 CAS 操作的线程安全 ID 生成器。与之前的 synchronized 版本相比,它减少了锁的竞争开销。在多线程测试中,两个线程同时调用同一个 LongSupplier,由于底层使用了 AtomicLong 的 compareAndSet 方法,确保了序列号的递增是原子性的。这证明了 LongSupplier 可以作为线程安全组件的代理接口,供并发环境使用。
当 LongSupplier 返回重复 ID 时可能的原因是什么
如果在使用 LongSupplier 获取分布式 ID 时发现重复值,最常见的原因是时钟回拨或 Worker ID 冲突。雪花算法依赖系统时间,如果服务器时间被手动调整或 NTP 同步导致时间倒退,可能会生成相同的 ID。此外,如果在不同的 JVM 实例或容器中配置了相同的 workerId,且没有全局唯一的标识机制,也会导致 ID 碰撞。另一个潜在问题是序列化或反序列化过程中丢失了高位信息,或者错误地将 ID 转换为 int 类型导致截断。

















