








apple芯片mac可以按tensorfold官方快速开始用homebrew安装引擎,下载其支持的固定模型修订,然后在本机启动服务。服务端不需要为推理另装python或mlx,但仍需要模型权重、足够内存和匹配的模型格式;不能把引擎支持metal理解成所有hugging face模型都能直接运行。
安装并下载官方入门模型
brew install ashhart/tensorfold/tensorfold
tensorfold pull mlx-community/Qwen3.5-2B-MLX-4bit@93760be4f1f69842a46bc13dbdc0f19e291392a3
该示例使用官方README列出的固定修订。下载前核对模型自身许可证与可用磁盘空间;pull会校验下载内容,并为已知模型族检查model_type,下载中断可继续取得缺少的分片。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
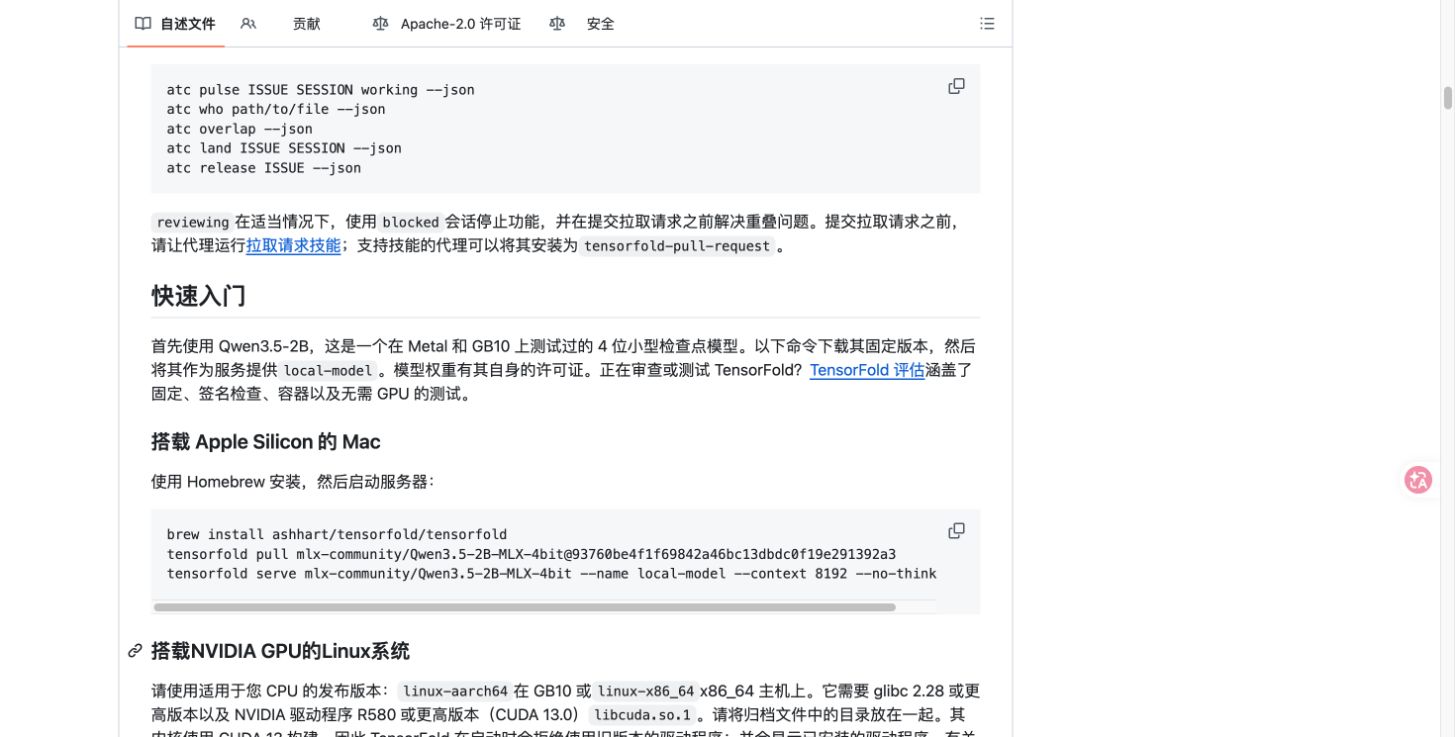
TensorFold官方快速开始给出Apple芯片Mac安装与启动命令
启动固定名称的文本服务
tensorfold serve mlx-community/Qwen3.5-2B-MLX-4bit --name local-model --context 8192 --no-thinking
保留服务终端运行。默认兼容接口基址为http://127.0.0.1:8080/v1,示例上下文8192是当前服务设置,不是对所有模型的统一最大值。--no-thinking应结合目标模型模板支持情况使用,不能假定任何模型都能用同一种方式切换思考。

Analyze Video By Qwen Free
下载
Qwen 视频智能分析基础客户端(免费版),基于 Qwen 3.5 Plus 多模态模型对本地视频进行内容分析,支持场景描述与基础内容理解,采用默认抽帧频率和提示词,适合快速概览视频,API Key 读取自 ~/.skill-platform/skill-platform.json 的 skills 配置。
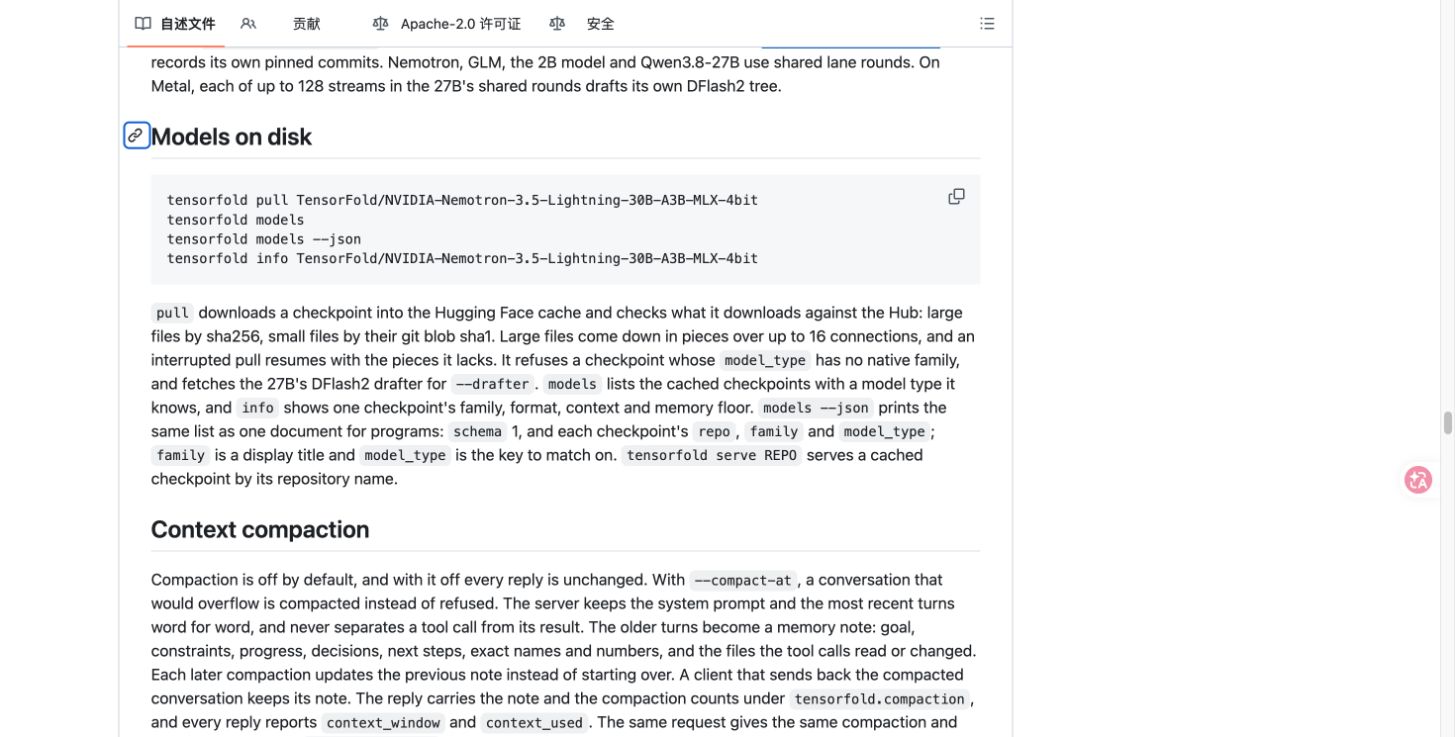
官方模型管理章节说明缓存检查与模型信息命令
检查本地缓存与模型状态
tensorfold models
tensorfold info mlx-community/Qwen3.5-2B-MLX-4bit
curl --fail-with-body http://127.0.0.1:8080/health
models列出引擎识别的缓存模型,info用于核对模型族、格式、上下文和内存下限。健康请求只验证服务在响应,不等于完成了模型质量或并发压测;再用一个短文本请求确认生成。若启动拒绝模型或资源不足,应按具体提示调整,不能靠增大上下文解决内存缺口。






















