








在java stream的distinct()中使用lambda表达式,核心在于为对象定义唯一的识别逻辑。由于stream api内置的distinct()方法仅支持基于object.equals()的默认去重,无法直接接收自定义比较器,因此必须通过收集到linkedhashset或treeset中并指定comparator来实现。具体做法是调用stream().collect(collectors.tocollection(() -> new linkedhashset(comparator.comparing(...)))),利用set的不可重复性结合lambda定义的键值提取规则完成去重。

如何对简单对象按单个字段去重
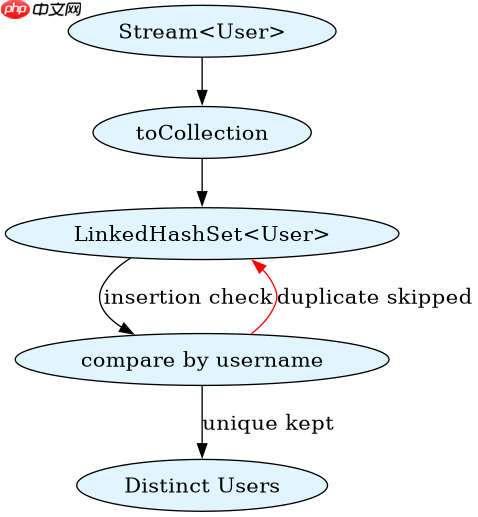
针对包含单一关键字段的实体类,可以直接使用Comparator.comparing提取该字段进行比较。例如处理一组User对象时,若希望根据username去除重复项,只需将lambda表达式传入comparing方法即可。这种方式代码简洁,且能保持元素在流中的原始顺序。
import java.util.*;
import java.util.stream.*;

public class Main {
    public static void main(String[] args) {
        List<User> users = Arrays.asList(
            new User(1, "Alice"),
            new User(2, "Bob"),
            new User(3, "Alice")
        );

        List<User> distinctUsers = users.stream()
            .collect(Collectors.toCollection(
                () -> new LinkedHashSet<>(Comparator.comparing(User::getUsername))
            ))
            .stream()
            .collect(Collectors.toList());

        System.out.println(distinctUsers);
    }
}

class User {
    int id;
    String username;
    User(int id, String username) { this.id = id; this.username = username; }
    public String getUsername() { return username; }
    @Override public String toString() { return "User{" + id + ", '" + username + "'}"; }
}
运行上述代码,预期输出结果为:[User{1, 'Alice'}, User{2, 'Bob'}]。可以看到,第三个User对象虽然id不同,但username与第一个相同,因此被过滤掉。最终列表保留了首次出现的Alice和Bob,顺序未变。
立即学习“Java免费学习笔记(深入)”;

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
如何处理复杂对象的多字段组合去重
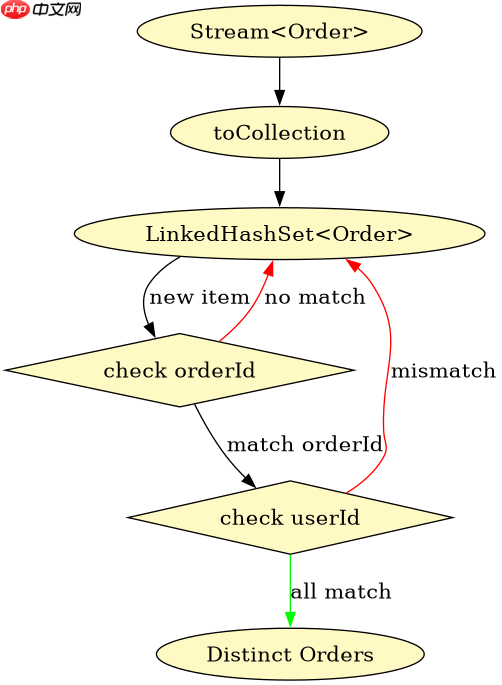
当去重条件涉及多个字段时,可以使用Comparator.thenComparing链式调用构建复合比较器。这在处理如订单数据(需同时匹配订单号和用户ID)时非常有效。通过组合多个字段的比较逻辑,可以精确控制哪些对象被视为“重复”。
import java.util.*;
import java.util.stream.*;

public class Main {
    public static void main(String[] args) {
        List<Order> orders = Arrays.asList(
            new Order("ORD001", "U1", 100),
            new Order("ORD002", "U1", 50),
            new Order("ORD001", "U1", 200)
        );

        List<Order> distinctOrders = orders.stream()
            .collect(Collectors.toCollection(
                () -> new LinkedHashSet<>(Comparator
                    .comparing(Order::getOrderId)
                    .thenComparing(Order::getUserId)
                )
            ))
            .stream()
            .collect(Collectors.toList());

        System.out.println(distinctOrders);
    }
}

class Order {
    String orderId;
    String userId;
    double amount;
    Order(String orderId, String userId, double amount) {
        this.orderId = orderId; this.userId = userId; this.amount = amount;
    }
    public String getOrderId() { return orderId; }
    public String getUserId() { return userId; }
    @Override public String toString() { return "Order{" + orderId + ", " + userId + ", " + amount + "}"; }
}
执行该程序,预期输出为:[Order{ORD001, U1, 100.0}, Order{ORD002, U1, 50.0}]。第三个订单虽然金额不同,但其orderId和userId与前一个完全一致,故被判定为重复项移除。此方法确保了多字段组合的唯一性校验。
基于程序中某个输入、条件或结果的具体问题
在上述示例中,输入数据包含具有相同业务键但不同其他属性的对象。条件是使用了LinkedHashSet配合Comparator进行去重。结果是保留了第一次遇到的实例,后续相同键值的实例被丢弃。这种机制保证了去重后的集合既满足唯一性约束,又维持了原始流的插入顺序,适用于需要稳定排序的去重场景。



















