








在java中使用lambda表达式配合arrays.sort进行并行排序,核心方法是调用重载版本 arrays.sort(t[] a, int fromindex, int toindex, comparator super t> c) 并传入一个自定义的 comparator。对于对象数组,直接传入lambda即可;对于基本类型数组(如 int[]),由于不支持泛型比较器,需先装箱为包装类数组或使用流式api处理。该操作利用forkjoinpool.commonpool()实现多线程分治排序,适用于数据量较大且cpu资源充足的场景。

如何对对象数组使用Lambda进行并行排序
针对对象数组,可以直接使用 Arrays.sort() 的重载方法,将Lambda表达式作为 Comparator 参数传入。这种方法利用了Java 8引入的并行排序特性,底层基于TimSort算法的多线程实现。当数组规模超过阈值时,JVM会自动将任务拆分到多个线程中执行,从而提升排序效率。
import java.util.Arrays;
import java.util.Comparator;

public class ParallelObjectSort {
    public static void main(String[] args) {
        String[] names = {"Charlie", "Alice", "Bob", "David"};

        // 使用Lambda定义比较逻辑
        Comparator<String> comparator = (s1, s2) -> s1.compareToIgnoreCase(s2);

        // 执行并行排序
        Arrays.parallelSort(names, comparator);

        System.out.println(Arrays.toString(names));
    }
}
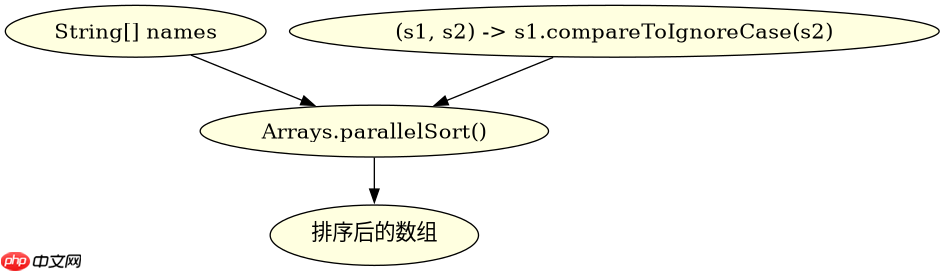
上述代码中,names 数组被传入 Arrays.parallelSort,第二个参数是Lambda表达式定义的 Comparator。运行后,数组按字典序(忽略大小写)排列,输出结果为 [Alice, Bob, Charlie, David]。注意,parallelSort 会修改原数组,若需保留原顺序,应先复制数组。此外,Lambda中的比较逻辑必须保持一致性,否则可能导致不可预测的结果。
立即学习“Java免费学习笔记(深入)”;

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
如何处理基本类型数组的并行排序
基本类型数组(如 int[]、double[])无法直接使用Lambda比较器,因为 Arrays.sort(int[], ...) 没有接受 Comparator 的重载版本。解决方案是将基本类型转换为包装类数组,或使用Stream API进行并行处理。推荐做法是使用 IntStream.range() 结合 boxed() 和 sorted() 方法,通过Lambda指定排序规则。

import java.util.Arrays;
import java.util.stream.IntStream;

public class ParallelPrimitiveSort {
    public static void main(String[] args) {
        int[] numbers = {5, 2, 9, 1, 7};

        // 转换为Integer数组并并行排序
        Integer[] boxed = IntStream.of(numbers).boxed().toArray(Integer[]::new);
        Arrays.parallelSort(boxed, (a, b) -> Integer.compare(a, b));

        // 转回int数组
        int[] sorted = Arrays.stream(boxed).mapToInt(Integer::intValue).toArray();
        System.out.println(Arrays.toString(sorted));
    }
}
此示例中,numbers 首先通过 IntStream.of() 转换为流,再经 boxed() 转为 Integer[] 数组。随后调用 Arrays.parallelSort() 并传入Lambda比较器 (a, b) -> Integer.compare(a, b)。最终结果 [1, 2, 5, 7, 9] 验证了排序正确性。虽然涉及装箱开销,但这是目前最简洁的处理方式。若性能敏感,可考虑手动实现并行归并排序,避免装箱带来的内存压力。
并行排序在空数组或单元素数组时的行为表现
当输入数组为空或仅含一个元素时,Arrays.parallelSort() 不会启动任何线程,直接返回原数组引用。这是因为并行处理的 overhead(线程创建、任务调度)大于收益,JVM内部会检测数组长度并跳过并行化步骤。例如,传入长度为0或1的数组,无论是否提供Lambda比较器,都不会触发ForkJoinPool的任务提交,确保轻量级操作的零开销。


















