








java.util.hashmap 在 jdk 9 及更高版本中,底层数据结构由“数组 + 链表”升级为“数组 + 链表 + 红黑树”,以解决哈希冲突严重时的性能退化问题。当链表长度超过阈值(默认 8)且数组容量达到扩容阈值(默认 64)时,链表会自动转换为红黑树,将查找时间复杂度从 o(n) 优化为 o(log n)。开发者无需手动干预这一过程,只需确保正确初始化 hashmap 并合理设置初始容量即可。
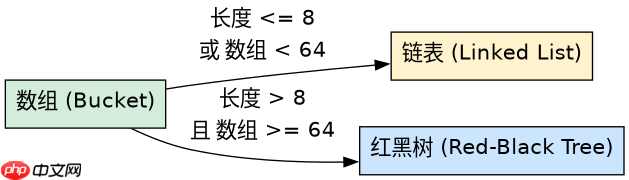
JDK 9 HashMap 的底层结构是如何演进的?
JDK 9 引入红黑树的核心目的是优化极端哈希冲突下的性能。在旧版本中,如果大量键值对的哈希码相同或发生严重碰撞,链表会无限延长,导致查询效率急剧下降。JDK 8 开始引入树化机制,但 JDK 9 进一步优化了相关实现细节和内存布局。树化并非仅看链表长度,还受数组大小限制,这是为了防止在小数组上构建庞大的树结构造成资源浪费。
import java.util.HashMap;
import java.util.Map;

public class HashMapTreeTest {
    public static void main(String[] args) {
        // 创建一个初始容量较大的 HashMap
        Map<String, Integer> map = new HashMap<>(100);

        // 插入数据触发树化:需要至少 8 个节点且数组容量 >= 64
        for (int i = 0; i < 10; i++) {
            // 使用相同的哈希码模拟冲突,例如 "test" 的哈希码
            String key = "test" + i;
            map.put(key, i);
        }

        System.out.println("Size: " + map.size());
        System.out.println("Contains 'test0': " + map.containsKey("test0"));
    }
}
上述代码演示了基本的 HashMap 操作。虽然示例中使用了不同的字符串,但在实际高冲突场景下,若哈希函数设计不佳,可能导致多个键映射到同一桶。此时,JVM 内部会自动检测链表长度,并在满足条件时将其转为红黑树。运行该程序后,控制台将输出 Size: 10 以及 Contains 'test0': true,证明数据正常存储与检索。
立即学习“Java免费学习笔记(深入)”;

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
如何控制 HashMap 的树化与退化行为?
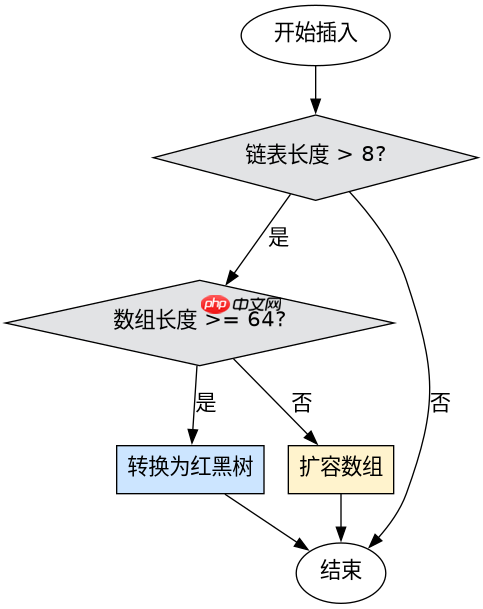
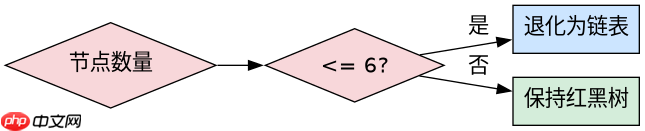
开发者可以通过构造函数参数影响 HashMap 的行为,但无法直接禁用树化或强制树化。树化的触发条件是:链表长度 > TREEIFY_THRESHOLD (8) 且 数组长度 >= MIN_TREEIFY_CAPACITY (64)。如果数组长度不足 64,即使链表很长,也会先进行扩容而非树化。退化发生在树节点数量减少到 UNTREEIFY_THRESHOLD (6) 以下时,树会重新变回链表,以节省内存开销。
import java.util.HashMap;
import java.util.Map;

public class HashMapResizeTest {
    public static void main(String[] args) {
        // 设置初始容量为 16,负载因子 0.75
        Map<String, Integer> map = new HashMap<>(16, 0.75f);

        // 插入 10 个具有相同哈希码的键
        for (int i = 0; i < 10; i++) {
            map.put("hashCollision", i);
        }

        // 由于数组长度仅为 16,小于 64,因此不会树化,而是扩容
        // 扩容后数组长度变为 32,仍小于 64,继续不树化
        // 只有当数组长度达到 64 以上且链表长度超过 8 时才会树化

        System.out.println("Final Size: " + map.size());
    }
}
此代码展示了扩容与树化的关系。在初始容量较小(如 16)的情况下,即使插入大量冲突键,HashMap 也会优先选择扩容来分散元素,而不是立即构建红黑树。只有当数组规模足够大(>=64)时,树化机制才会生效。最终输出为 Final Size: 10,表明数据已成功存入,但未触发树化结构,因为数组容量未达到阈值。
HashMap 在什么条件下会从红黑树退化为链表?
当红黑树中的节点数量因删除操作减少到 6 个或以下时,HashMap 会自动将树结构退化回链表。这一机制旨在平衡性能与内存占用。树结构虽然查询快,但维护成本高、内存占用大;而链表结构简单,适合小规模数据存储。退化过程是自动的,无需开发者干预,确保了在不同数据量级下都能保持最优的资源利用效率。



















