








输入用户提问,关键操作是构建向量库并执行相似度匹配,产出为精准召回的上下文片段。通过对比关键词与语义向量的差异,可以直观看到AI如何理解“意思相近”而非“字面相同”,从而在搭建知识库时避免误匹配和幻觉。
区分字面匹配与语义理解
当用户询问“怎么请假?”时,传统关键词搜索可能只返回包含这两个字的文档,而语义检索能识别出“请假流程是?”或“休假规定”等同义表达。这是因为系统将文本转化为数字向量,如[0.12, 0.78, 0.31...],通过计算向量间的距离来判断含义是否相近,而非仅仅比对字符重合度。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
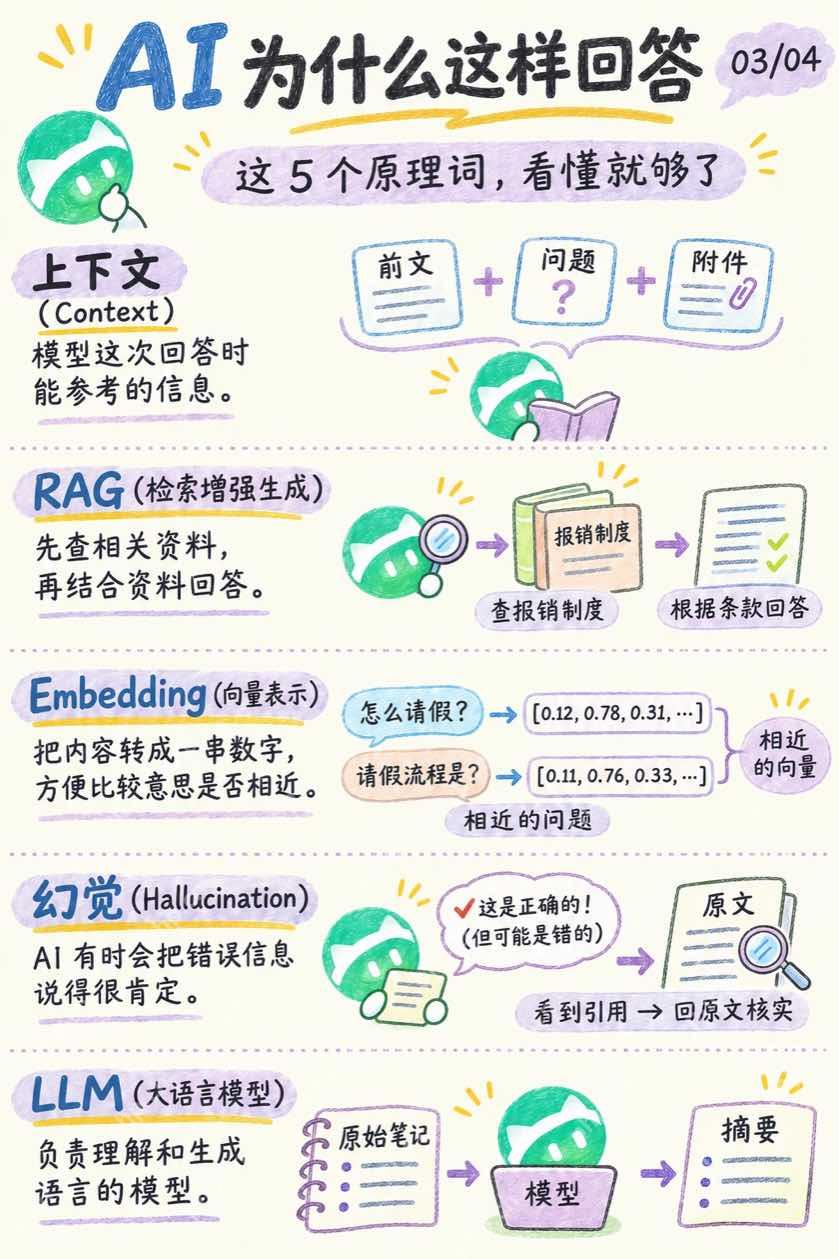
图片展示了Embedding(向量表示)的核心逻辑:将自然语言转换为数值序列。即使问题表述不同,只要语义核心一致,生成的向量在空间中就会彼此靠近。这种机制让模型能够捕捉到“相近的问题”,但需注意,向量相似度高并不等同于答案正确,仍需结合原文核实。
RAG流程中的上下文构建
检索增强生成(RAG)流程分为两步:先查相关资料,再结合资料回答。系统首先利用向量数据库检索与用户问题最相关的片段,这些片段构成Context(上下文)。例如,查询报销制度时,系统会提取相关条款作为依据,确保LLM(大语言模型)基于事实而非内部记忆进行生成。
在此过程中,原始笔记被摘要化处理或直接切片存入向量库。当用户发起请求,系统召回的是经过Embedding处理的片段。关键在于,模型负责理解和生成语言,而检索模块负责提供准确的外部知识。这种分离架构有效降低了模型因训练数据截止或偏差导致的错误。
防范幻觉与验证引用
AI有时会把错误信息说得很肯定,这种现象称为幻觉(Hallucination)。即便向量检索找到了“相近”的内容,如果该片段本身存在歧义或与最新政策冲突,模型仍可能生成误导性回答。因此,必须建立核对机制,要求模型在输出时引用具体来源,以便人工回原文核实。
端到端知识库搭建与RAG流程的区别在于控制粒度。RAG允许在每次问答时动态检索最新信息,而静态知识库则依赖定期更新。在实际操作中,应优先检查召回片段的时效性和准确性,因为“这是正确的!但可能是错的”警示我们,语义匹配仅解决相关性,不保证事实性。






















