








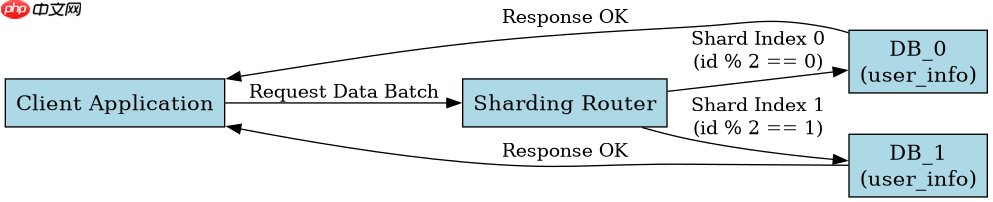
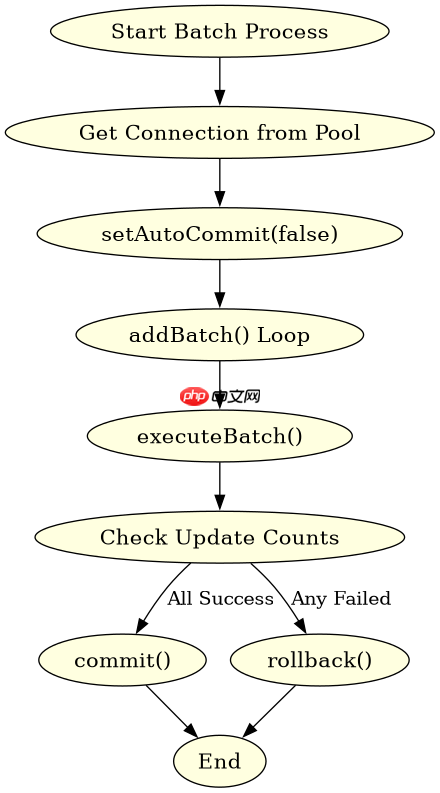
java jdbc 实现批量操作分库分表的核心在于根据路由规则将数据拆分到不同的物理连接中,并在每个连接内部开启独立事务进行批量提交。具体做法是预先建立多个 datasource 实例对应不同分片,通过 shardingkey 或主键哈希确定目标库表,随后获取对应 connection 并设置手动提交模式,使用 preparedstatement.addbatch() 累积 sql,最后调用 executebatch() 执行并提交。若某一分片失败,需确保已提交的分片不受影响,通常采用最终一致性补偿机制而非分布式事务。
如何根据数据特征选择分库分表策略
选择分库分表策略主要依据业务数据的访问模式和增长预期。常见策略包括水平分表(按 ID 取模)、垂直分库(按业务模块拆分)以及混合模式。对于高并发写入场景,基于时间戳或用户 ID 的哈希取模能有效分散负载;而对于需要关联查询的场景,则需考虑是否接受跨库 JOIN 的性能损耗。确定策略后,需在代码中实现对应的路由逻辑,确保同一批次的数据能正确映射到指定的物理节点。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.util.HashMap;
import java.util.Map;

public class ShardingBatchExample {
    // 模拟两个数据源配置
    private static final String URL_1 = "jdbc:mysql://localhost:3306/db_0";
    private static final String URL_2 = "jdbc:mysql://localhost:3306/db_1";
    private static final String USER = "root";
    private static final String PASSWORD = "password";

    public static void main(String[] args) {
        Map<Long, String> shardingMap = new HashMap<>();
        shardingMap.put(0L, URL_1);
        shardingMap.put(1L, URL_2);

        // 假设有一批待处理数据,ID 为 100-109
        for (long id = 100; id <= 109; id++) {
            int shardIndex = (int) (id % 2); // 简单取模分片
            String url = shardingMap.get((long) shardIndex);
            processBatch(id, url);
        }
    }

    private static void processBatch(long id, String url) {
        try (Connection conn = DriverManager.getConnection(url, USER, PASSWORD)) {
            conn.setAutoCommit(false); // 开启事务
            String sql = "INSERT INTO user_info (id, name) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                pstmt.setLong(1, id);
                pstmt.setString(2, "User_" + id);
                pstmt.addBatch();

                // 每10条提交一次,避免内存溢出
                if ((id - 100) % 10 == 0) {
                    pstmt.executeBatch();
                    conn.commit();
                }
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
上述代码展示了基础的分片逻辑。通过 id % 2 将数据分配到两个不同的数据库 URL。每个分片内部独立管理事务,确保批量插入的原子性。实际生产中,建议使用连接池如 HikariCP 替代原生驱动获取连接,以提高性能。

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
立即学习“Java免费学习笔记(深入)”;
如何处理批量操作中的异常与回滚
在分库分表环境下,单个分片的失败不应导致整个批次的全局回滚,因为其他分片可能已成功提交。正确的做法是在每个分片的事务块中捕获异常,记录错误日志,并根据业务需求决定是重试、跳过还是标记为待补偿。JDBC 的 executeBatch() 方法会返回一个整数数组,指示每条语句的执行状态,开发者需遍历该数组判断是否有 BIGINT 类型的 EXECUTE_FAILED 返回值。对于部分失败的情况,应保留成功提交的数据,后续通过异步任务修复不一致数据。
import java.sql.BatchUpdateException;
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.util.Arrays;

public class BatchExceptionHandler {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/db_0";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            conn.setAutoCommit(false);
            String sql = "INSERT INTO orders (order_id, amount) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                for (int i = 0; i < 5; i++) {
                    pstmt.setInt(1, 1000 + i);
                    pstmt.setDouble(2, 100.0 * i);
                    pstmt.addBatch();
                }

                int[] results = pstmt.executeBatch();
                conn.commit();

                // 检查结果
                for (int i = 0; i < results.length; i++) {
                    if (results[i] == java.sql.Statement.SUCCESS_NO_INFO ||
                        results[i] == java.sql.Statement.EXECUTE_OK) {
                        System.out.println("Row " + i + " succeeded.");
                    } else {
                        System.out.println("Row " + i + " failed with code: " + results[i]);
                    }
                }
            } catch (BatchUpdateException e) {
                // 处理批量更新异常
                int[] updateCounts = e.getUpdateCounts();
                for (int i = 0; i < updateCounts.length; i++) {
                    if (updateCounts[i] == java.sql.Statement.EXECUTE_FAILED) {
                        System.err.println("Failed at index: " + i);
                    }
                }
                conn.rollback(); // 仅在全部失败或业务要求全回滚时执行
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
此示例演示了如何通过检查 executeBatch() 的返回值来识别部分失败。当遇到 BatchUpdateException 时,可以通过 getUpdateCounts() 定位具体失败的行。这种细粒度的错误处理允许系统在分片环境中保持更高的可用性,避免因局部故障引发全局雪崩。
当单批次数据量超过内存限制时该如何优化
当单批次数据量极大时,将所有 SQL 加入 addBatch() 会导致内存溢出(OOM)。优化方案是将大数据集拆分为多个小批次,例如每次处理 1000 条记录,分批提交。此外,可以使用流式处理或游标方式读取数据,避免一次性加载所有结果集到内存。在写入端,除了分批提交外,还可以调整 MySQL 的 max_allowed_packet 参数以支持更大的单包 SQL,但需谨慎评估网络带宽和服务器负载。另一种高级优化是使用 JDBC 的 rewriteBatchedStatements=true 参数,它会将多条 INSERT 语句合并为一条多值 INSERT,显著提升吞吐量。



















