








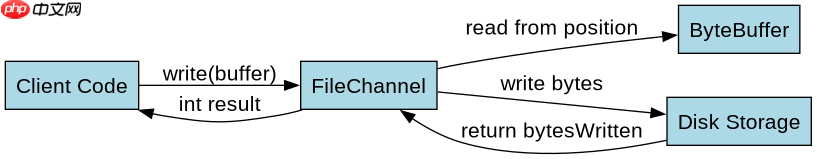
java nio 中 filechannel 的 write() 方法用于将数据从缓冲区写入文件通道。调用时传入一个继承自 bytebuffer 的实例,该方法会返回实际写入的字节数,并自动更新缓冲区的 position 指针。若需指定写入位置,应使用带 long position 参数的重载版本,此时不会改变缓冲区的 position。
如何向文件追加内容而不覆盖现有数据
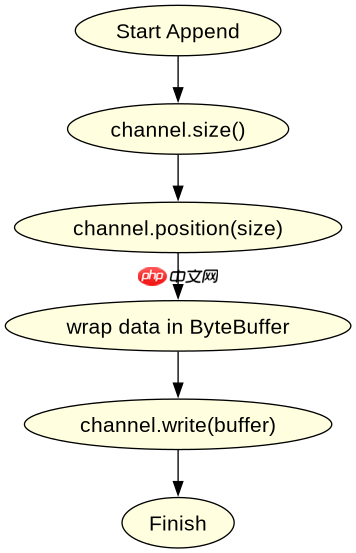
要实现追加写入,必须先将 FileChannel 定位到文件末尾。通过调用 channel.size() 获取当前文件大小,再使用 channel.position(size) 将写入指针移至该位置,随后执行 write() 即可实现追加效果。
import java.io.RandomAccessFile;
import java.nio.ByteBuffer;
import java.nio.channels.FileChannel;

public class AppendExample {
    public static void main(String[] args) throws Exception {
        // 以读写模式打开文件,确保可以定位到末尾
        try (RandomAccessFile raf = new RandomAccessFile("test.txt", "rw");
             FileChannel channel = raf.getChannel()) {

            // 获取当前文件大小并定位到末尾
            long size = channel.size();
            channel.position(size);

            // 准备数据
            String data = "\nAppended Line";
            ByteBuffer buffer = ByteBuffer.wrap(data.getBytes());

            // 执行写入
            int bytesWritten = channel.write(buffer);
            System.out.println("Wrote: " + bytesWritten + " bytes");
        }
    }
}
上述代码首先通过 RandomAccessFile 获取 FileChannel,接着利用 size() 和 position() 确保写入点在文件尾部。最后将字符串转为 ByteBuffer 并调用 write()。预期结果是原文件内容保持不变,新内容被附加在末尾,控制台打印出实际写入的字节数。
立即学习“Java免费学习笔记(深入)”;

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
如何处理 write() 返回值不足的情况
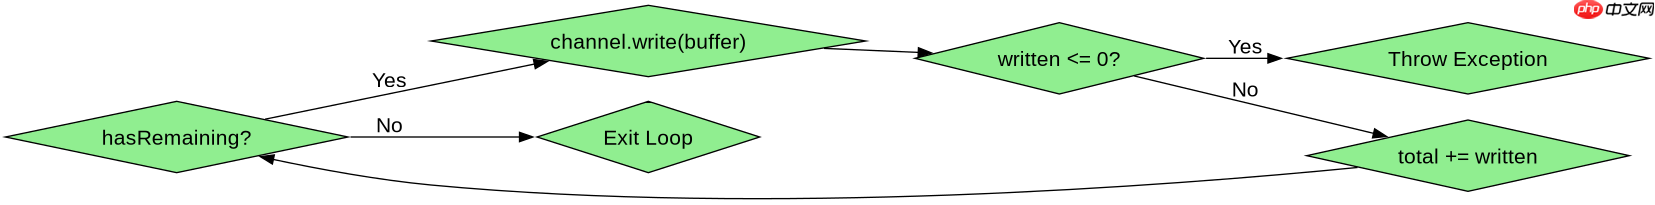
write() 方法不保证一次性写入缓冲区中的所有数据,可能因系统限制或缓冲区状态只写入部分字节。因此,必须检查返回值,并在循环中继续写入剩余数据,直到缓冲区完全清空或发生异常。
import java.io.RandomAccessFile;
import java.nio.ByteBuffer;
import java.nio.channels.FileChannel;

public class WriteLoopExample {
    public static void main(String[] args) throws Exception {
        try (RandomAccessFile raf = new RandomAccessFile("output.bin", "rw");
             FileChannel channel = raf.getChannel()) {

            // 创建包含大量数据的缓冲区
            byte[] largeData = new byte[1024 * 1024]; // 1MB
            for (int i = 0; i < largeData.length; i++) {
                largeData[i] = (byte) (i % 256);
            }

            ByteBuffer buffer = ByteBuffer.wrap(largeData);
            long totalWritten = 0;

            // 循环写入直到所有数据发出
            while (buffer.hasRemaining()) {
                int written = channel.write(buffer);
                if (written <= 0) {
                    throw new RuntimeException("Write failed or stalled");
                }
                totalWritten += written;
            }

            System.out.println("Total bytes written: " + totalWritten);
        }
    }
}
此示例展示了处理大文件写入的标准模式。由于 write() 可能返回小于缓冲区容量的值,代码使用 while (buffer.hasRemaining()) 循环调用 write(),累加返回值直至缓冲区为空。这种写法确保了无论底层实现如何限制单次写入量,所有数据都能成功写入文件。
基于 position 参数写入特定偏移量的行为差异
当使用 write(ByteBuffer src, long position) 时,写入操作不会影响缓冲区的 position 和 limit 属性,这与无参版本不同。这意味着你可以多次向同一缓冲区的不同文件偏移量写入相同的数据,而无需手动重置缓冲区。
例如,若有一个包含 "Hello" 的 ByteBuffer,调用 channel.write(buffer, 0) 后,缓冲区 position 仍为初始值。再次调用 channel.write(buffer, 5) 会将相同内容写入文件偏移量 5 处。这种行为适用于需要随机访问写入的场景,避免了频繁翻转或重置缓冲区的开销。

















