








与其每次让AI模仿语气,不如通过结构化分析,将写作风格拆解为六个维度的具体规则,从而生成可保存、可验证的“写作DNA”,实现从形似到神似的稳定输出。
很多创作者在使用ai辅助写作时,常遇到一个痛点:开头几段像目标作者,但正文很快又变回通用的ai套路。这是因为单纯的“模仿语气”只触及了表层,而真正的风格是由语言习惯、结构逻辑、选题视角等深层因素共同构成的。要解决这个问题,核心思路是将一种写作风格拆解为可复用的规则系统,而非仅仅依赖几句提示词。
这一过程被称为“写作风格蒸馏”。它不限对象,无论是个人博客、科技博主、媒体账号还是品牌文案,都可以提取其独特的写作基因。关键在于,不仅要关注表面的用词,更要深入挖掘作者观察问题和组织观点的方式。
从语气、段落和选题角度拆写作风格
要将风格转化为规则,首先需要建立完整的分析框架。一个成熟的写作风格通常包含以下六个层次,越往下的层次,越接近作者真正的思考内核:
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
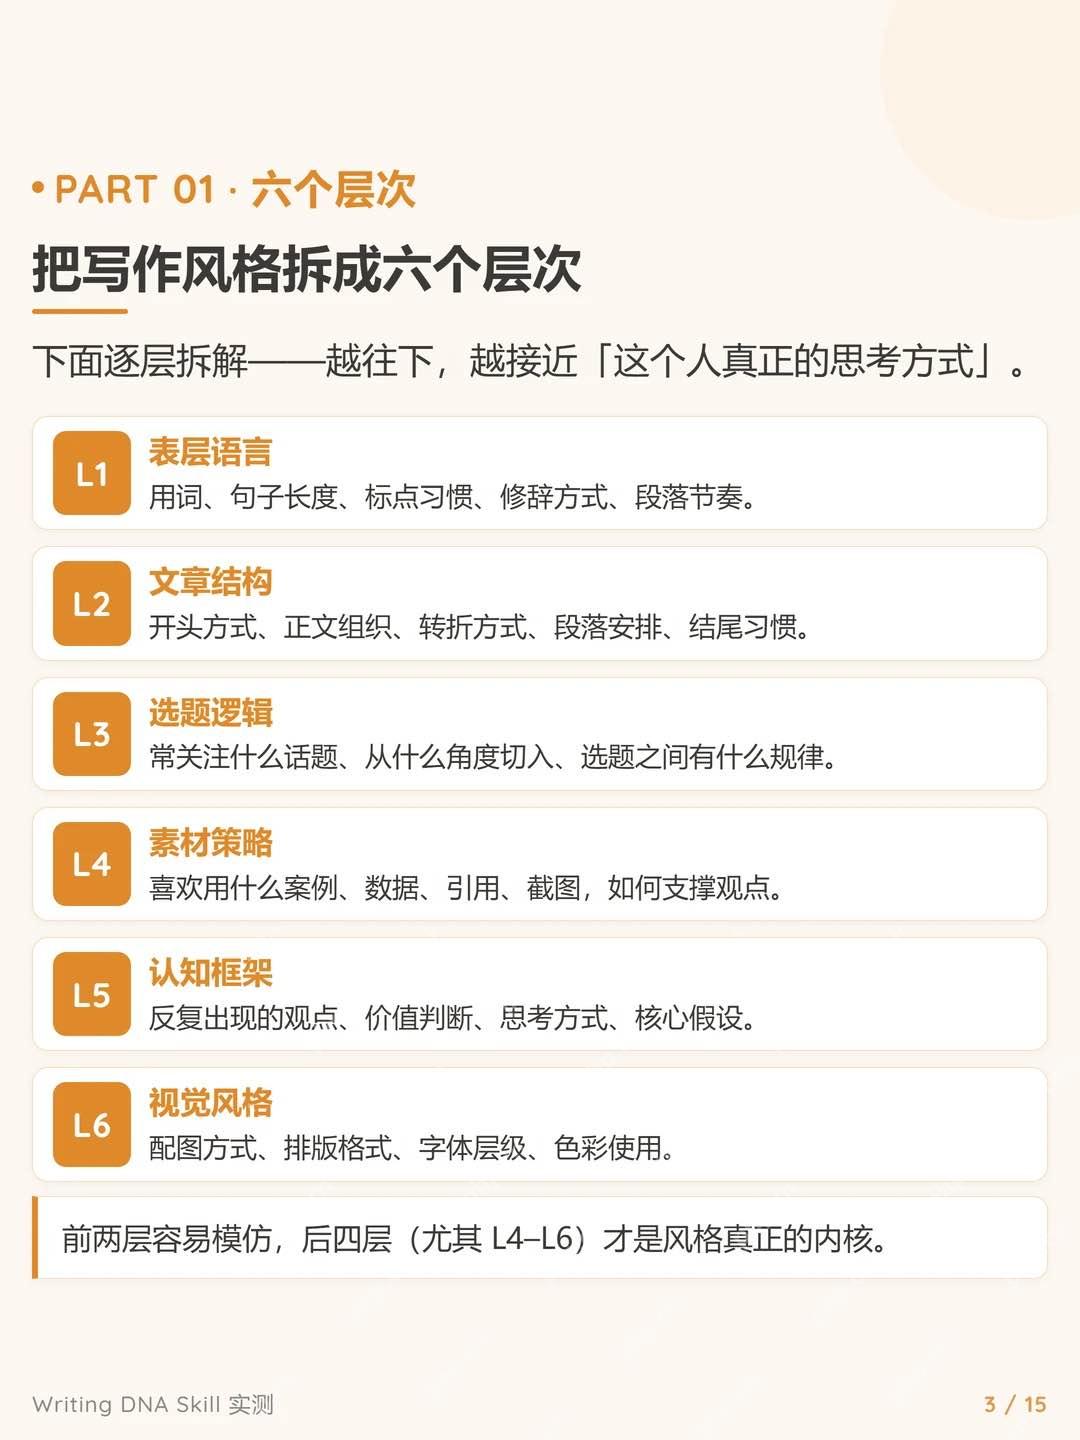
- L1 表层语言:包括用词偏好、句子长度、标点习惯、修辞方式以及段落节奏。这是最容易被模仿的部分,但也最容易流于表面。
- L2 文章结构:涉及开头方式、正文组织逻辑、转折手法、段落安排以及结尾习惯。
- L3 选题逻辑:分析作者常关注的话题、切入角度以及选题之间的内在规律。
- L4 素材策略:观察作者喜欢使用的案例类型、数据引用、截图方式以及如何支撑观点。
- L5 认知框架:这是风格的核心。包括反复出现的观点、价值判断、思考方式和核心假设。例如,面对同一个AI工具,有人关注技术先进性,有人关注效率提升,有人关注工作流整合。这种视角差异决定了文章的“灵魂”。
- L6 视觉风格:配图方式、排版格式、字体层级和色彩使用规范。
在实际操作中,L1和L2相对容易捕捉,但L4至L6(尤其是L5认知框架)才是区分普通模仿与深度复刻的关键。如果AI只学习了语言表达而未理解内容上的视角差异,写出的文章依然缺乏辨识度。
给不同类型的样稿建好目录
蒸馏效果的质量直接取决于输入语料的纯净度和数量。建议每组测试对象至少准备20篇高质量文章。样本太少会导致AI将偶然表达误认为固定习惯;样本充足才能区分稳定特征与噪声。
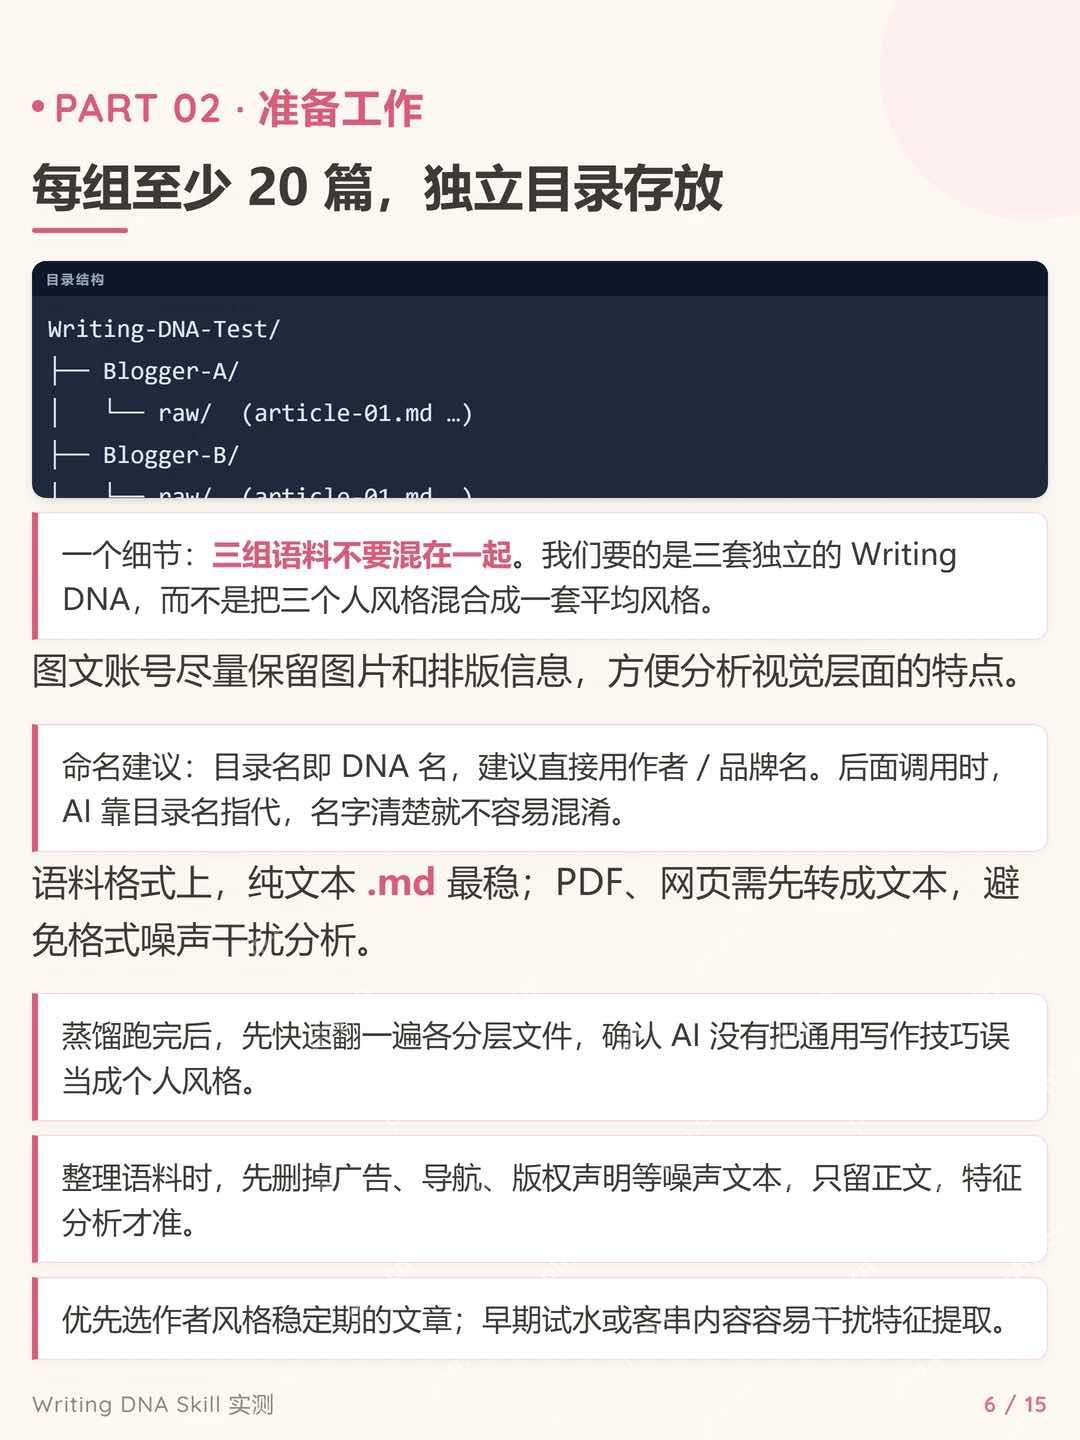
在整理语料时,需遵循以下规范:
- 独立存放:不同作者或品牌的文章必须放在独立的目录中,避免混合导致风格平均化。
- 去噪处理:删除广告、导航栏、版权声明等非正文内容,仅保留纯文本或Markdown格式。PDF或网页需先转换为文本,避免格式干扰。
- 命名清晰:目录名建议直接使用作者或品牌名称,便于后续调用时指代。
- 筛选稳定期作品:优先选择作者风格成熟期的文章,避开早期试水或客串内容,以减少特征提取的偏差。
让 AI 把样稿里的写法整理成规则
准备好语料后,可以使用专门的写作风格蒸馏工具(如Writing DNA Skill)。关键在于提示词的设计:不要只说“分析风格”,而要明确指定分析目标和输出结构,迫使AI进行分层提炼。
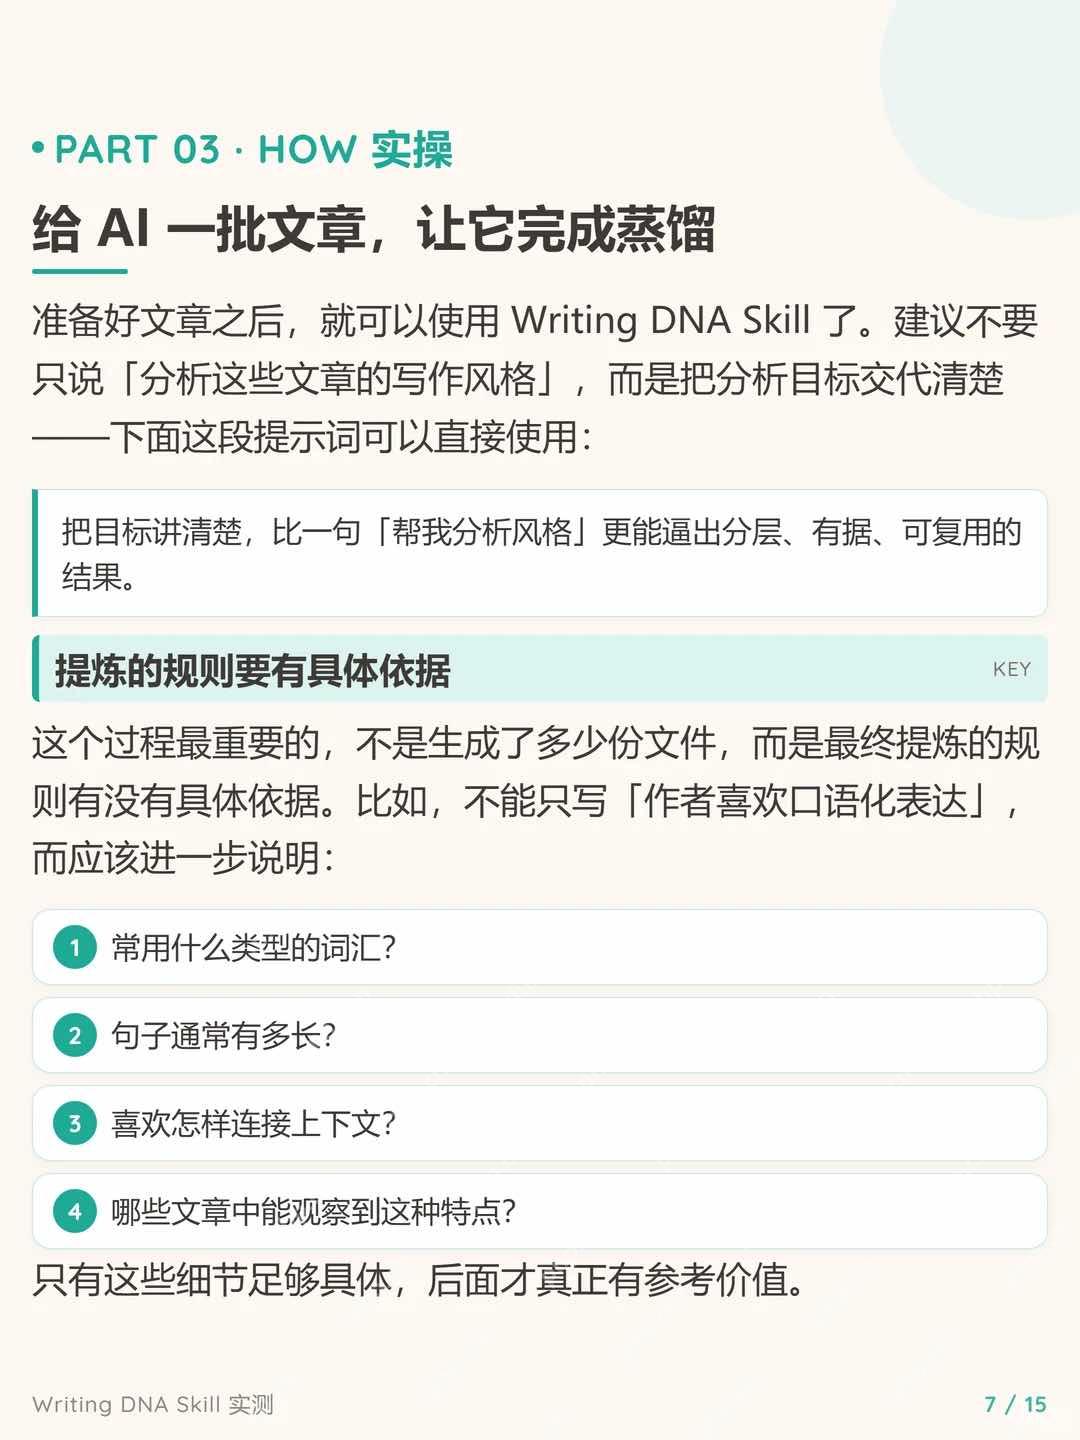
以下是一个可直接使用的标准提示词模板,适用于Agent或高级LLM环境:
请使用 writing-dna-skill,对当前目录中的文章进行完整的写作风格蒸馏。
本次任务:分析目标作者的写作风格,并生成独立的 Writing DNA.
具体要求:
•完整阅读当前目录中的原始文章。
•按六个层次分析:L1 表层语言/L2 文章结构/L3选题逻辑/L4 素材策略/
L5 认知框架/L6视觉风格。
•区分稳定的写作习惯和偶然出现的表达。
•分析不同文章类型之间的结构差异。
•每个重要结论尽量提供原文依据。
•不要把通用写作技巧误认为目标作者的个人风格。
•证据不足的判断,明确标注。
最终输出:Writing-DNA.md、语言DNA.md、文章结构模板.md、写作视角
与认知框架.md、视觉风格指南.md。所有分析结果单独保存在当前作者目录
中,不要与其他作者混合。
运行完成后,会在对应目录下生成五个分层文件。这些文件包含了具体的词汇偏好、结构模板、认知视角和视觉指南。后续创作时,只需调用对应的DNA文件作为上下文,即可让AI按照该特定风格持续产出内容,无需反复调整提示词。
用同一个选题试写,检查规则有没有用
蒸馏并非一劳永逸。生成规则后,应选取同一主题,分别使用“通用AI风格”和“蒸馏后的DNA风格”生成两篇文章进行对比。重点检查L5认知框架是否准确还原,以及L1-L2的语言习惯是否自然连贯。若发现AI仍陷入套路化表达,需回溯检查语料中是否混入了噪声,或补充更多典型样本重新训练。
通过这种方式,写作风格不再是一种模糊的感觉,而是一套可保存、可分析、可重复使用的工程化资产。






















