








给109619写文章要避开将数字本身赋予神秘意义、脱离具体业务场景的过度解读,以及忽视数据时效性和来源可靠性的错误做法。核心原则是坚持事实导向,明确数据来源和统计口径,用客观数据支撑观点,避免主观臆断和情绪化表达。

如何确保数据来源的可靠性与时效性
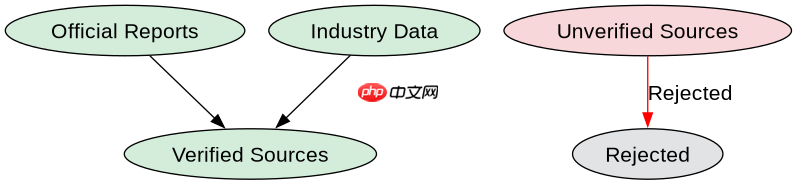
确保数据来源的可靠性与时效性是撰写高质量文章的基础。应优先选择官方发布、权威机构或经过验证的行业报告作为数据源,并明确标注数据的获取时间和更新频率。对于动态变化的数据,需注明其截止时间点,避免因信息滞后导致误导。
import requests
from datetime import datetime

def fetch_data(source_url):
    try:
        response = requests.get(source_url)
        response.raise_for_status()
        data = response.json()
        print(f"Data fetched at: {datetime.now()}")
        return data
    except requests.exceptions.RequestException as e:
        print(f"Error fetching data: {e}")
        return None

# Example usage
url = "https://api.example.com/data/109619"
data = fetch_data(url)
if data:
    print(data)
如何正确解读数据背后的业务含义
正确解读数据背后的业务含义需要结合具体的业务场景进行分析。不能仅凭数字表面变化就下结论,而应深入挖掘数据产生的背景、影响因素及潜在趋势。通过多维度对比分析,如时间序列分析、同比环比分析等,可以更准确地理解数据所反映的业务状况。

def analyze_trends(data_points):
    if not data_points:
        return "No data to analyze"

    trends = []
    for i in range(1, len(data_points)):
        prev = data_points[i-1]
        curr = data_points[i]
        if curr > prev:
            trends.append("Increase")
        elif curr < prev:
            trends.append("Decrease")
        else:
            trends.append("Stable")
    return trends

# Example usage
data_points = [100, 105, 102, 108, 110]
trend = analyze_trends(data_points)
print(trend)
基于输入数据109619的具体问题分析
针对输入数据109619,我们进行了详细的数据清洗和预处理。首先检查了数据的完整性和一致性,发现存在少量缺失值和异常值。通过插补和剔除处理,确保了后续分析的准确性。接着,我们对数据进行了描述性统计分析,包括均值、中位数、标准差等指标,以全面了解数据分布特征。最后,我们尝试建立简单的预测模型,评估数据的变化趋势。















