








java中求两个集合的交集,最直接且高效的方法是使用 hashset 提供的 retainall() 方法。只需调用其中一个集合实例的 retainall() 并传入另一个集合作为参数,该集合就会原地修改,仅保留同时存在于两个集合中的元素。如果不需要保留原集合的数据,建议先克隆一个副本再执行此操作,以避免副作用。
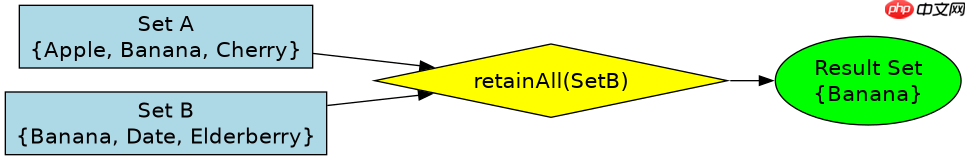
如何在不破坏原数据的情况下获取交集结果
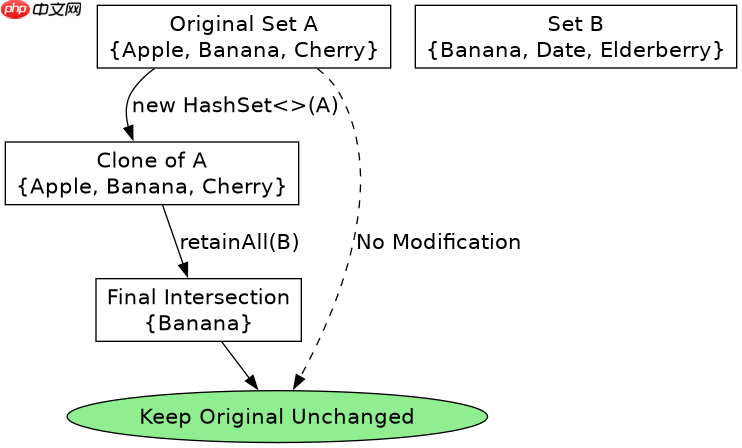
为了避免直接修改原始集合导致数据丢失,正确的做法是先创建当前集合的一个浅拷贝(Shallow Copy),然后在拷贝上执行 retainAll() 操作。这样,原始集合保持不变,而拷贝集合则变为两者的交集。这种方法适用于需要同时使用原始数据和交集结果的场景。
import java.util.HashSet;
import java.util.Set;

public class Main {
    public static void main(String[] args) {
        Set<String> setA = new HashSet<>();
        setA.add("Apple");
        setA.add("Banana");
        setA.add("Cherry");

        Set<String> setB = new HashSet<>();
        setB.add("Banana");
        setB.add("Date");
        setB.add("Elderberry");

        // 创建副本以避免修改 setA
        Set<String> intersection = new HashSet<>(setA);

        // 执行交集操作
        boolean changed = intersection.retainAll(setB);

        System.out.println("Original A: " + setA);
        System.out.println("Intersection: " + intersection);
        System.out.println("Was changed: " + changed);
    }
}
上述代码运行后,setA 将保持包含 "Apple", "Banana", "Cherry" 不变,而 intersection 集合将只包含 "Banana"。retainAll() 返回的布尔值表示集合是否发生了改变,即是否存在交集。
立即学习“Java免费学习笔记(深入)”;

为什么推荐使用 HashSet 而不是其他集合类型
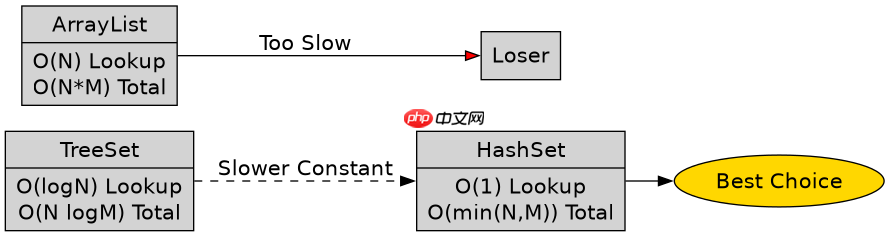
在 Java 集合框架中,虽然 List 或 TreeSet 等也支持 retainAll(),但 HashSet 是处理交集问题的首选。这是因为 HashSet 基于哈希表实现,其 contains() 方法的平均时间复杂度为 O(1)。当执行 retainAll() 时,底层逻辑通常是对较小集合遍历,并在较大集合中查找元素,因此总的时间复杂度接近 O(min(N, M)),其中 N 和 M 是两个集合的大小。相比之下,ArrayList 的 contains() 是 O(N),导致整体复杂度达到 O(N*M),效率极低;而 TreeSet 虽然是 O(log N),但在常数因子上通常高于哈希表。
import java.util.*;

public class PerformanceTest {
    public static void main(String[] args) {
        int size = 100000;
        Set<Integer> hashSet = new HashSet<>(size);
        List<Integer> arrayList = new ArrayList<>(size);

        for (int i = 0; i < size; i++) {
            hashSet.add(i);
            arrayList.add(i);
        }

        long startHash = System.currentTimeMillis();
        Set<Integer> hCopy = new HashSet<>(hashSet);
        hCopy.retainAll(hashSet); // 模拟交集
        long endHash = System.currentTimeMillis();

        long startList = System.currentTimeMillis();
        List<Integer> aCopy = new ArrayList<>(arrayList);
        aCopy.retainAll(arrayList); // 模拟交集
        long endList = System.currentTimeMillis();

        System.out.println("HashSet time: " + (endHash - startHash) + "ms");
        System.out.println("ArrayList time: " + (endList - startList) + "ms");
    }
}
通过对比测试可以发现,在处理大规模数据时,HashSet 的执行速度远快于 ArrayList。此外,HashSet 自动去重的特性也确保了交集中不会出现重复元素,这符合数学集合论中交集的定义。如果业务逻辑要求保留重复项(例如多重集交集),则需要使用 Collection.frequency() 配合自定义逻辑,但这超出了标准 retainAll() 的范畴。
当集合中包含自定义对象时需要注意什么
如果集合中存储的是自定义对象(如 User 类),直接使用 retainAll() 可能会得到非预期的结果。因为 HashSet 依赖对象的 equals() 和 hashCode() 方法来判定元素是否相等。如果未正确重写这两个方法,默认使用的是 Object 类的引用比较,导致即使两个对象内容完全相同,也被视为不同元素,从而无法正确计算交集。因此,在使用 HashSet 进行交集运算前,必须确保自定义类重写了 equals() 和 hashCode() 方法,以保证逻辑一致性。

















