








auto ontology 查询数据时,先让语义编译就绪,再到 chat 输入带有商品、地区和时间的具体问题。拿到答案后,展开 sql 检查统计口径,必要时回到数据库复核。
在 Chat 里查询某款商品的月营收
打开已经导入Wide World Importers数据集的实例,确认语义编译全部完成,进入对话界面,输入官方快速入门里的营收查询问题。问题里要包含完整商品名、所属州、对应月份三个要素,后续生成的SQL里每一项都能逐一核对。
What was revenue for the USB food flash drive - sushi roll in Pennsylvania in June 2015?
官方快速入门给出的示例结果是 588.80 美元,对应 3 条发票明细记录,对话功能会同步返回生成的 SQL 语句和结果视图。
换成不同商品营收、客户数对比类的问题,系统也会同时返回SQL和图表两种结果。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
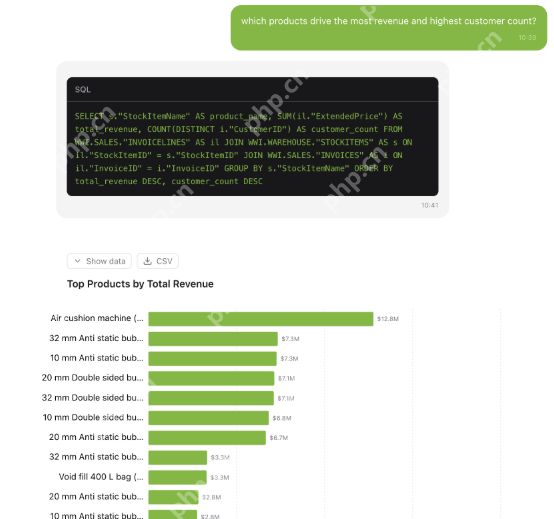
怎么核对生成的 SQL?
先检查 SUM(il.extendedprice) 调用的字段是否正确,再核对筛选条件里的商品、所属州有没有准确匹配。时间筛选这里用的是包含 6 月 1 日、排除 7 月 1 日的半开区间逻辑,官方例题对应的完整 SQL 如下。
下面列出官方示例 SQL 的筛选条件。复核时,从 Chat 展开并复制完整 SQL。
WHERE si.stockitemname = 'USB food flash drive - sushi roll'
AND sp.stateprovincename = 'Pennsylvania'
AND i.invoicedate >= '2015-06-01' AND i.invoicedate < '2015-07-01';
对照数据库查询结果
用带只读权限的 PostgreSQL 客户端连接同一个练习数据库,执行上面的 SQL,核对返回的总金额和行数。对话返回的行数据、导出的 CSV 都和这条 SQL 的执行结果完全对应。注意这个例题用了聚合逻辑,如果想看3条原始发票明细,得单独写明细查询,不能直接把这一行汇总结果当成底层的原始记录。
答案为空或金额有差异时查哪里?
先缩小排查范围,一开始只留一个筛选条件验证,确认没问题之后再把商品、州、月份的筛选条件逐个加回去。如果排查发现是 SQL 的关联键写错了,回到语义模型页面检查术语映射和表关联关系。
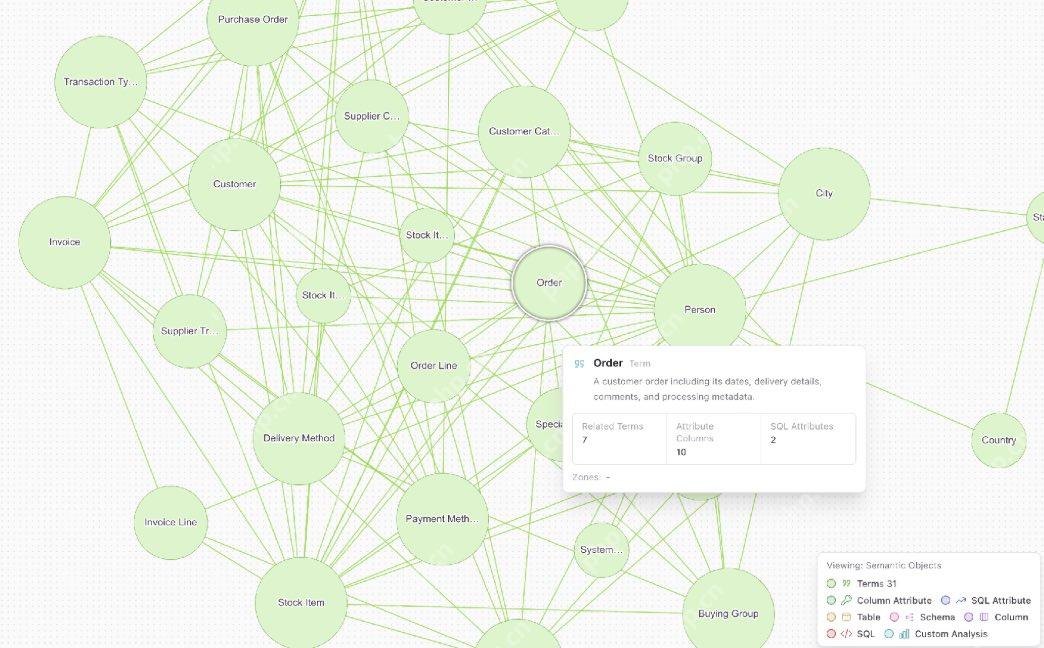
如果要查询的指标换成广告投入回报率,得先确认当前数据源里有没有广告支出相关的字段。官方示例里就是通过 MCP 的 check_answerable 能力检测到该指标缺失,之后才单独把可正常查询的营收问题拎出来做演示。





















