








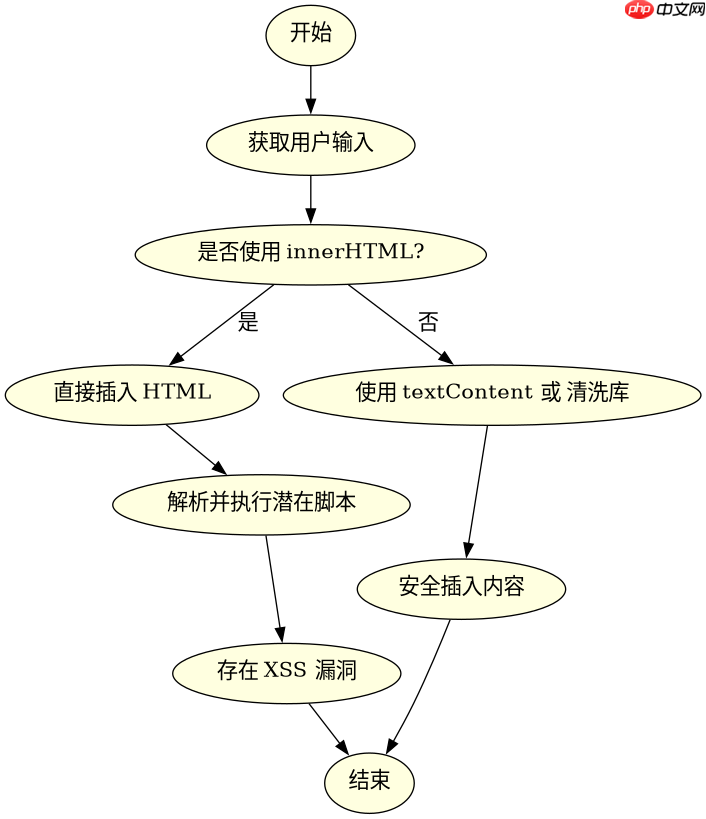
使用 textcontent 属性赋值是防止 xss 的最安全做法,因为它会将用户输入作为纯文本处理,浏览器会自动转义其中的 html 特殊字符,从而阻止脚本执行。如果必须插入 html 结构,应使用 dompurify 等库对内容进行清洗,或者通过创建元素节点并逐个设置属性的方式构建 dom,避免直接使用 innerhtml。
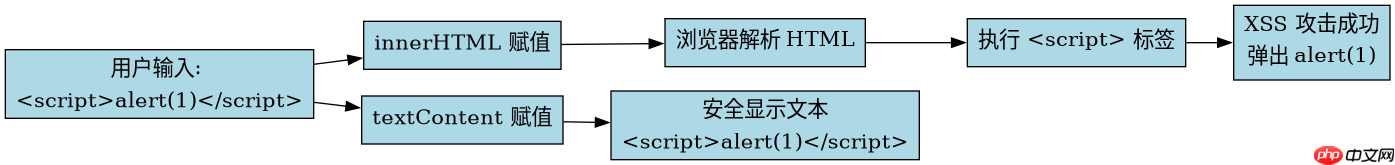
为什么 innerHTML 会导致 XSS 漏洞
当使用 innerHTML 插入包含恶意脚本的用户输入时,浏览器会解析并执行这些脚本。例如,如果用户输入 <script>alert(1)</script>,直接赋值给 innerHTML 会导致弹窗。这是因为 innerHTML 将字符串解析为 HTML 标记,而不仅仅是文本内容。
const userInput = '<img  src=x onerror=alert(1) alt="JavaScript 节点操作中怎么安全插入用户输入内容防止XSS" >';
const container = document.getElementById('app');
// 危险操作:直接插入 HTML
container.innerHTML = userInput;上述代码中,userInput 包含一个带有 onerror 事件处理程序的 img 标签。当这段 HTML 被插入到 DOM 中时,浏览器尝试加载不存在的图片源 x,触发错误后执行 alert(1)。这就是典型的 XSS 攻击向量。
立即学习“Java免费学习笔记(深入)”;

如何安全地插入 HTML 内容
如果需要保留用户的格式(如粗体、链接),可以使用 DOMParser 或第三方库来清洗 HTML。这里演示使用 DOMParser 结合白名单策略的安全插入方法。首先解析 HTML,然后遍历节点,移除所有非白名单允许的标签和属性。

function sanitizeHTML(html) {
  const doc = new DOMParser().parseFromString(html, 'text/html');
  const walker = document.createTreeWalker(doc.body, NodeFilter.SHOW_ELEMENT);
  const allowedTags = ['b', 'i', 'u', 'a'];

  while (walker.nextNode()) {
    const node = walker.currentNode;
    if (!allowedTags.includes(node.tagName.toLowerCase())) {
      node.parentNode.removeChild(node);
    } else if (node.tagName.toLowerCase() === 'a') {
      // 只允许 href 属性,且必须是 http/https 开头
      const href = node.getAttribute('href');
      if (!href || !href.startsWith('http')) {
        node.parentNode.removeChild(node);
      }
    }
  }
  return doc.body.innerHTML;
}
该函数接收原始 HTML 字符串,返回经过清洗的 HTML。它移除了所有不在白名单中的标签,并对 a 标签的 href 进行了严格校验。这样可以在一定程度上保留用户想要的格式,同时防止恶意脚本注入。
基于程序输出结果的具体问题
在上面的 sanitizeHTML 函数中,如果用户输入的是 <b>Hello</b><script>alert(1)</script>,最终输出的 HTML 是什么?
最终输出的 HTML 是 <b>Hello</b>。因为 <script></script> 标签不在白名单中,所以被移除。而 <b></b> 标签在白名单中,且没有需要移除的属性,所以被保留。这证明了白名单策略的有效性,但同时也意味着任何不在白名单中的标签都会被丢弃,包括 div、span 等常用标签,因此这种方法适用于对格式要求不高的场景。

















