








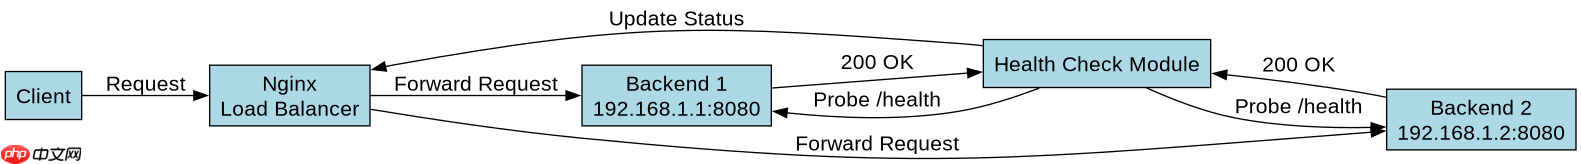
在 linux 中,nginx 结合健康检查模块实现故障转移的核心做法是:使用第三方模块(如 nginx-upstream-healthcheck)主动探测后端节点状态,并将结果反馈给负载均衡器。当某个后端节点的健康检查失败时,nginx 会自动将其从上游服务器列表中剔除,不再向其发送请求,从而实现自动故障转移。
如何配置 Nginx 进行主动健康检查
要启用主动健康检查,需要在 Nginx 的配置文件中加载 healthcheck 模块,并在 upstream 块中定义检查规则。通过设置 health_check 指令,指定检查的 URI、超时时间和间隔时间。Nginx 会定期向这些 URI 发送 HTTP 请求,根据返回的状态码判断后端是否存活。
server {
    listen 80;
    location / {
        proxy_pass http://backend_pool;
    }
}

upstream backend_pool {
    server 192.168.1.1:8080;
    server 192.168.1.2:8080;

    # 配置健康检查
    health_check uri=/health interval=5 fail_timeout=10;
}
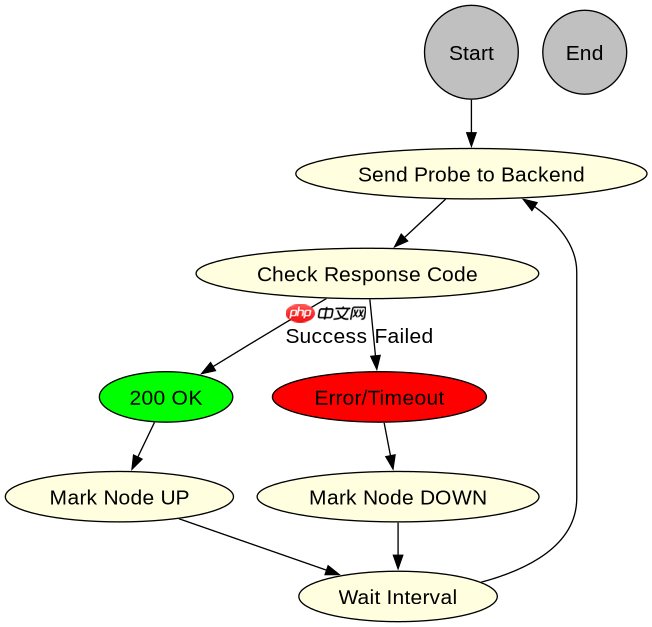
在上述配置中,interval=5 表示每 5 秒进行一次健康检查,fail_timeout=10 表示如果连续 10 次检查失败,该节点将被标记为不可用。检查的 URI 为 /health,后端应用需要在此路径上返回 200 OK 状态码以表明自身健康。
故障转移的具体行为与验证
当 Nginx 检测到某个后端节点的健康检查失败时,它会立即将该节点从可用池中移除。后续的请求将只分发到其他健康的节点上。这种机制确保了即使部分后端服务出现故障,整体服务依然能够正常运行。

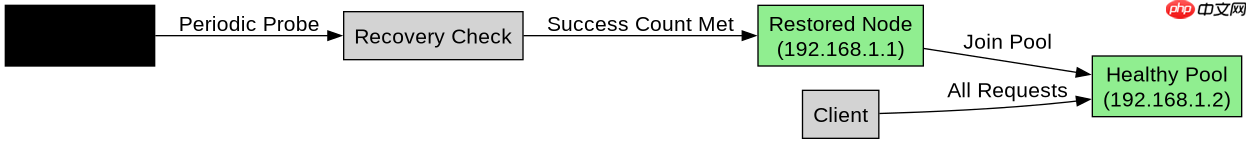
# 模拟后端节点 192.168.1.1 宕机
# Nginx 日志中会出现类似以下的错误信息
[error] 1234#0: *1 connect() failed (111: Connection refused) while connecting to upstream, client: 192.168.1.100, server: example.com, request: "GET / HTTP/1.1", upstream: "http://192.168.1.1:8080", host: "example.com"

# 此时,所有新的请求将被转发到 192.168.1.2
为了验证故障转移是否生效,可以手动停止其中一个后端服务,然后观察 Nginx 的错误日志和访问日志。如果错误日志中开始出现连接被拒绝的错误,且访问日志中不再有针对该节点的请求,则说明故障转移已成功触发。此外,可以通过 curl -I http://localhost/health 命令查看 Nginx 自身的健康检查接口状态(如果启用了状态监控),或者通过查看 Nginx 的 stub_status 模块输出来间接确认上游服务器的状态变化。
基于健康检查失败后的节点恢复机制
当之前发生故障的后端节点恢复服务后,Nginx 并不会立即将其重新加入可用池,而是需要等待下一次健康检查成功。这个恢复过程依赖于 fail_timeout 和 max_fails 参数(如果使用了内置的轮询或加权轮询算法配合 down 标记)。对于第三方健康检查模块,通常有一个独立的恢复逻辑,即当连续多次健康检查成功后,节点会被重新标记为 up 状态。
例如,如果配置了 interval=5 和 fail_timeout=10,并且假设模块默认要求连续 2 次检查成功才恢复,那么节点恢复大约需要 10 秒。在此期间,Nginx 会继续将流量导向其他健康节点,确保服务的连续性。开发者可以通过调整 interval 和恢复所需的成功次数来平衡故障检测的速度和服务恢复的稳定性。



















