








使用 fetch 发起请求后,调用返回的 response 对象的 .text() 方法获取原始字符串。由于 smile 是二进制格式,浏览器端的 fetch api 无法直接解析为 json,必须将其作为文本或 arraybuffer 处理,并引入专门的库(如 smile-js)进行反序列化。

如何从 fetch 响应中获取 Smile 字节流
通过设置 responseType 或使用 arrayBuffer() 可以获取底层数据。Smile 数据通常以二进制形式传输,因此需要确保 HTTP 头中的 Content-Type 正确标识,并在客户端正确处理二进制流。

const response = await fetch('/api/smile-data');
const buffer = await response.arrayBuffer();
console.log(buffer.byteLength); // 输出字节长度
如何在浏览器端反序列化 Smile 数据
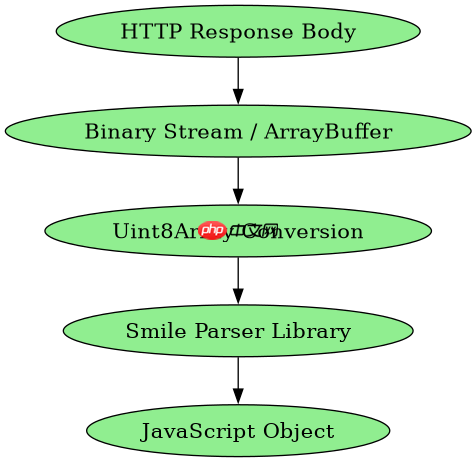
获取到 Buffer 后,需将其转换为库可接受的格式(如 Uint8Array),然后调用解析函数。不同库的实现略有差异,但核心步骤一致:转换格式 -> 调用解析器 -> 获得 JavaScript 对象。
立即学习“Java免费学习笔记(深入)”;
import { decode } from 'smile-js';

const uint8Array = new Uint8Array(buffer);
const result = decode(uint8Array);
console.log(result); // 输出解析后的 JS 对象
如果接口返回的是 UTF-8 编码的 Smile 文本怎么办
某些场景下,Smile 数据可能被 Base64 编码或以文本形式传输。此时需先解码 Base64 或提取文本,再转为字节数组进行解析。若直接当作 JSON 解析会报错,因为 Smile 不是 JSON。
const textResponse = await response.text();
// 假设是 Base64 编码的 Smile
const binaryString = atob(textResponse);
const bytes = new Uint8Array(binaryString.length);
for (let i = 0; i < binaryString.length; i++) {
    bytes[i] = binaryString.charCodeAt(i);
}
const parsed = decode(bytes); // 使用 smile-js 等库解析 














