








使用 fetch 获取 rtf 数据时,应调用 response.arraybuffer() 方法将响应体转换为二进制缓冲区,随后通过 textdecoder 将其解码为字符串。这样做能确保包含特殊字符或格式控制符的 rtf 内容被完整保留,避免直接读取文本导致的编码损坏。
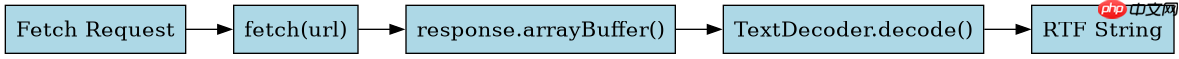
如何正确解析 RTF 字符串并提取纯文本
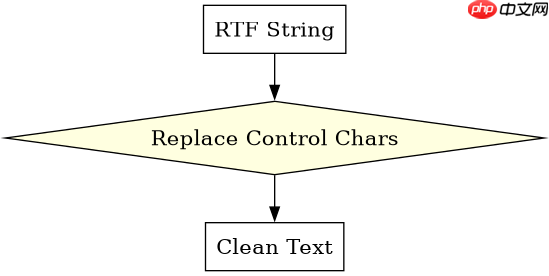
拿到解码后的 RTF 字符串后,需要剥离其中的格式标记以获取纯文本。可以通过正则表达式匹配并移除所有以反斜杠开头的命令组,或者利用浏览器内置的 DOMParser 将 RTF 视为 HTML 片段进行转换(需预处理)。最稳健的做法是使用专门的库如 rtf.js,但在原生环境下,简单的正则替换足以应对基础场景。
const rtfString = '{\rtf1\ansi{\fonttbl{\f0 Times New Roman;}}{\colortbl ;\red0\green0\blue0;} \pard \qc \b Hello World!\b0 \par}';

// 移除 RTF 控制符和组
const cleanText = rtfString.replace(/\[a-z]+(?:d+)?(?:\)?/g, '').replace(/[{}]/g, ' ').replace(/s+/g, ' ').trim();

console.log(cleanText); // 输出: Hello World!
如何处理非 UTF-8 编码的 RTF 数据
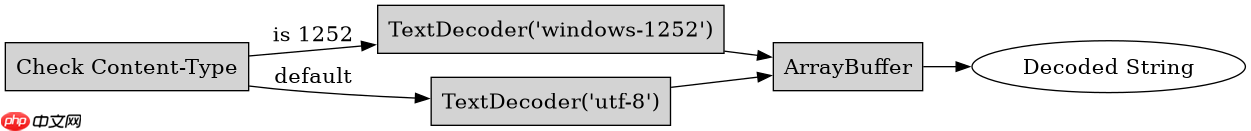
部分旧系统返回的 RTF 可能采用 ANSI 或特定代码页编码。此时直接使用 TextDecoder('utf-8') 会产生乱码。应当先检查 HTTP 头部的 Content-Type 是否指定了 charset,若未指定或明确为其他编码(如 iso-8859-1),则需实例化对应的 TextDecoder 实例进行解码。

立即学习“Java免费学习笔记(深入)”;
async function fetchRTF(url) {
  const response = await fetch(url);
  const contentType = response.headers.get('Content-Type') || '';
  let decoder;

  if (contentType.includes('charset=windows-1252')) {
    decoder = new TextDecoder('windows-1252');
  } else {
    decoder = new TextDecoder('utf-8');
  }

  const buffer = await response.arrayBuffer();
  return decoder.decode(buffer);
}
基于程序中某个输入、条件或结果的具体问题
当接口返回空响应或网络请求失败时,response.arrayBuffer() 会抛出异常或返回空缓冲区。必须在调用该方法前检查 response.ok,否则后续解码步骤将因无效输入而中断。此外,对于超大 RTF 文件,一次性加载到内存可能导致性能瓶颈,此时应考虑流式处理或使用 Web Workers 隔离主线程。

















