








在 javascript 中实现 fetch api 请求数据预清洗,最稳妥的做法是封装一个自定义的 fetch 函数或 promise 代理对象。通过拦截响应流,在解析 json 之前对原始文本进行正则替换、类型转换或字段过滤,从而将非标准或脏数据转化为前端可直接使用的干净结构。

如何拦截并修改原始响应文本
直接回答:可以通过读取 response.text() 获取原始字符串,利用正则表达式或字符串方法完成清洗后,再手动调用 JSON.parse() 返回结果。这种方式绕过了默认的 response.json() 流程,允许你在解析前修正格式错误(如尾随逗号)或剔除无关字符。
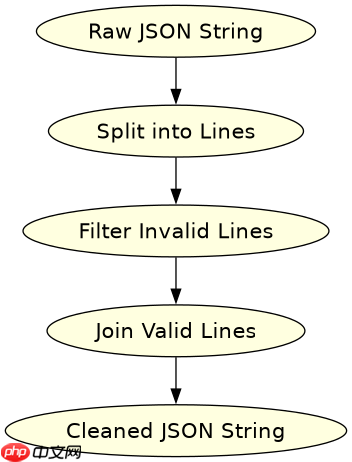
const cleanFetch = async (url, options) => {
  const response = await fetch(url, options);

  if (!response.ok) {
    throw new Error(`HTTP error! status: ${response.status}`);
  }

  // 1. 获取原始文本
  const rawText = await response.text();

  // 2. 预清洗逻辑示例:去除尾随逗号以兼容旧版 JSON 解析器
  const cleanedText = rawText.replace(/,(\s*[}\]])/g, '$1');

  // 3. 手动解析为 JSON
  try {
    return JSON.parse(cleanedText);
  } catch (e) {
    console.error('JSON parse error after cleaning:', e);
    throw e;
  }
};

// 使用示例
cleanFetch('/api/data').then(data => console.log(data));
上述代码展示了完整的拦截流程。首先调用 fetch 发起请求,随后立即调用 response.text() 而不是 json()。拿到字符串后,执行具体的清洗操作(例如本例中的正则替换)。最后,使用标准的 JSON.parse() 将清洗后的字符串转换为对象。如果清洗失败导致 JSON 格式依然非法,则抛出异常供上层捕获。
立即学习“Java免费学习笔记(深入)”;
如何在清洗过程中处理特定字段类型
直接回答:可以在获取到 JSON 对象后,遍历其属性或使用映射函数,针对特定字段进行类型强转或默认值填充。这种方法适用于后端返回的数据类型与前端预期不符的情况,例如日期字符串需要转为 Date 对象,或者空字符串需要转为 null。

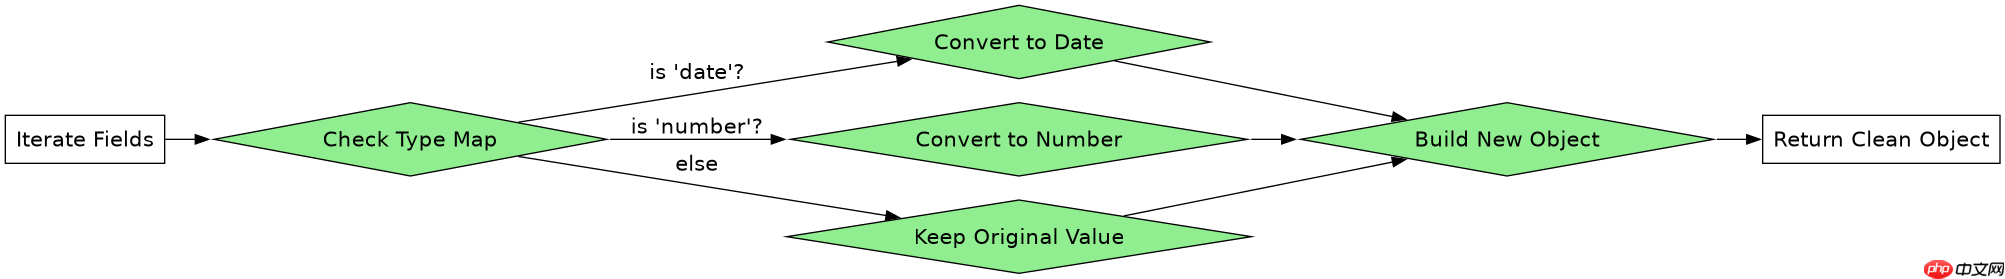
const typedCleanFetch = async (url, typeMap) => {
  const response = await fetch(url);
  const data = await response.json();

  // 假设 typeMap 定义了需要转换的字段及其目标类型
  // 例如: { 'created_at': 'date', 'user_id': 'number' }

  const cleanData = Object.keys(data).reduce((acc, key) => {
    let value = data[key];

    if (typeMap[key] === 'date') {
      acc[key] = new Date(value);
    } else if (typeMap[key] === 'number') {
      acc[key] = Number(value) || 0; // 处理空串转数字为 NaN 的情况
    } else {
      acc[key] = value;
    }

    return acc;
  }, {});

  return cleanData;
};

// 定义清洗规则
const rules = {
  'timestamp': 'date',
  'score': 'number'
};

typedCleanFetch('/api/info', rules).then(res => console.log(res));
这段代码演示了基于字段的类型清洗。它先通过标准的 response.json() 获取对象,然后利用 Object.keys 和 reduce 构建一个新的干净对象。通过传入 typeMap 配置,可以灵活指定哪些字段需要特殊处理。例如,将时间戳字符串转换为 Date 实例,或将可能为空的数值字段强制转为数字并提供默认值。这种方式比纯文本正则更结构化,适合处理复杂的业务数据模型。
当响应体包含非 JSON 头部时如何处理
直接回答:如果服务器返回的响应体不是合法的 JSON(例如开头包含了 HTML 注释、BOM 字节序标记或非 JSON 文本),需要在解析前剥离这些非 JSON 部分。可以通过查找第一个 { 或 [ 的位置来截取有效的 JSON 片段,确保 JSON.parse() 不会报错。
在实际开发中,某些老旧系统或调试接口可能会在 JSON 数据前附加说明文字。为了兼容这种情况,可以使用正则表达式定位 JSON 结构的起始位置。以下代码展示了如何从混合内容中提取有效 JSON:
const robustJsonParse = (text) => {
  // 查找第一个 { 或 [ 的位置
  const startMatch = text.match(/[\{\[]/);
  if (!startMatch) {
    throw new Error('No valid JSON structure found');
  }

  const startIndex = startMatch.index;
  const jsonPart = text.slice(startIndex);

  return JSON.parse(jsonPart);
};

// 模拟包含前缀的响应
const dirtyResponse = "<!-- debug info --> {\"id\": 1}";
console.log(robustJsonParse(dirtyResponse)); // { id: 1 }
该方案的核心在于定位 JSON 边界。通过 match 找到第一个左花括号或左方括号,然后使用 slice 截取从该位置开始的子串。这样即使响应体前面有大量的无效字符,只要后面紧跟合法的 JSON 结构,就能成功解析。这种策略特别适用于那些不严格遵守 MIME 类型规范的第三方 API。

















