








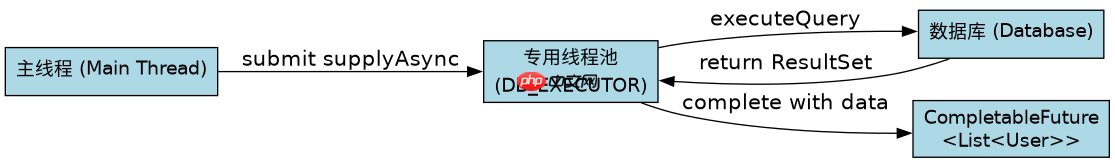
在 java 中实现异步数据库查询,核心思路是利用 completablefuture.supplyasync() 将耗时的 jdbc 操作提交到线程池执行,从而避免阻塞主线程。你需要创建一个独立的 executorservice(推荐使用自定义的 threadpoolexecutor),并在其中封装具体的数据库连接、sql 执行和结果集解析逻辑。这样调用方可以立即获得一个 completablefuture 对象,通过链式调用处理后续逻辑或等待最终结果。
如何配置专用的线程池以隔离数据库任务
为了避免数据库 I/O 密集型任务耗尽默认的公共线程池(如 ForkJoinPool)资源,必须显式创建专用的线程池。通常建议根据 CPU 核数和并发需求设置核心线程数,并指定无界队列或合理的拒绝策略。在代码中,我们定义一个静态的 DB_EXECUTOR 实例,专门用于承载所有异步 DB 查询任务,确保系统资源的隔离与稳定。
import java.util.concurrent.*;

public class AsyncDbConfig {
    // 专用线程池:核心线程数设为 CPU 核数 + 1,适合 I/O 密集型
    private static final ExecutorService DB_EXECUTOR = new ThreadPoolExecutor(
        Runtime.getRuntime().availableProcessors() + 1,
        Runtime.getRuntime().availableProcessors() * 2,
        60L, TimeUnit.SECONDS,
        new LinkedBlockingQueue<>(),
        new ThreadFactory() {
            private int count = 0;
            public Thread newThread(Runnable r) {
                Thread t = new Thread(r, "db-async-thread-" + count++);
                t.setDaemon(true);
                return t;
            }
        },
        new ThreadPoolExecutor.CallerRunsPolicy()
    );

    public static ExecutorService getDbExecutor() {
        return DB_EXECUTOR;
    }
}
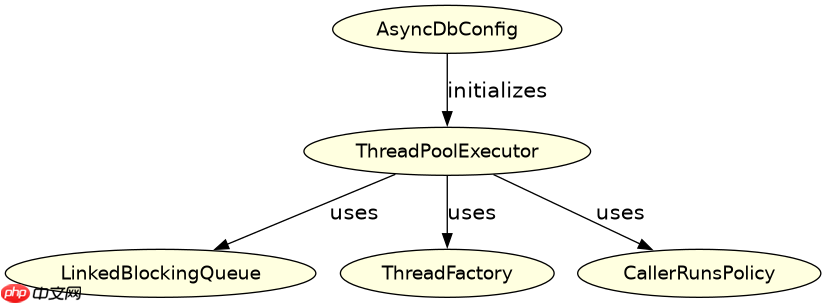
上述代码定义了一个名为 AsyncDbConfig 的配置类。它初始化了一个 ThreadPoolExecutor,核心线程数动态获取自 Runtime.getRuntime().availableProcessors()。这种配置方式确保了即使在高并发下,数据库查询也不会干扰主业务线程。调用方只需引用 AsyncDbConfig.getDbExecutor() 即可复用该线程池。
立即学习“Java免费学习笔记(深入)”;

如何将 JDBC 查询包装为 CompletableFuture
具体实现时,需将 Connection 的获取、Statement 的执行以及 ResultSet 的遍历全部包裹在 supplyAsync 的 Lambda 表达式中。由于 JDBC 并非原生异步,这里的“异步”实质是线程切换。我们需要在 Lambda 内部处理 SQLException,并将其转换为运行时异常抛出,以便 CompletableFuture 能正确捕获错误状态。返回的数据结构可以是简单的 List<map></map> 或自定义实体列表。

import java.sql.*;
import java.util.*;
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.Executor;

public class AsyncDbQuery {

    private static final String URL = "jdbc:h2:mem:testdb";
    private static final String USER = "sa";
    private static final String PASS = "";

    public static CompletableFuture<List<Map<String, Object>>> queryUsersAsync(Executor executor) {
        return CompletableFuture.supplyAsync(() -> {
            List<Map<String, Object>> results = new ArrayList<>();
            String sql = "SELECT id, name FROM users WHERE status = ?";
            try (Connection conn = DriverManager.getConnection(URL, USER, PASS);
                 PreparedStatement pstmt = conn.prepareStatement(sql)) {

                pstmt.setInt(1, 1);
                try (ResultSet rs = pstmt.executeQuery()) {
                    ResultSetMetaData meta = rs.getMetaData();
                    int columnCount = meta.getColumnCount();
                    while (rs.next()) {
                        Map<String, Object> row = new HashMap<>();
                        for (int i = 1; i <= columnCount; i++) {
                            row.put(meta.getColumnName(i), rs.getObject(i));
                        }
                        results.add(row);
                    }
                }
            } catch (SQLException e) {
                throw new RuntimeException("DB Query Failed", e);
            }
            return results;
        }, executor);
    }
}
这段代码展示了 queryUsersAsync 方法的具体实现。它接收一个 Executor 参数,内部使用 DriverManager.getConnection 建立连接。注意,所有的 SQL 执行逻辑都在 Lambda 体内同步完成,但整个块被提交到了指定的线程池中运行。如果发生 SQLException,代码将其包装为 RuntimeException 抛出,这是 CompletableFuture 处理受检异常的推荐做法。返回的 CompletableFuture 将在后台线程完成任务后自动进入完成状态。
如何处理异步查询中的异常与超时
在实际生产环境中,异步查询可能因网络抖动或数据库负载过高而失败或挂起。因此,必须在 CompletableFuture 链上配置异常处理和超时机制。可以使用 exceptionally() 提供降级数据或默认值,并使用 orTimeout() 或 completeOnTimeout() 防止任务无限期挂起。这些方法允许你在不中断主流程的前提下,优雅地处理边缘情况。
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.TimeUnit;
import java.util.List;
import java.util.Map;

public class AsyncDbHandler {

    public void processWithSafety() {
        CompletableFuture<List<Map<String, Object>>> future =
            AsyncDbQuery.queryUsersAsync(AsyncDbConfig.getDbExecutor());

        // 添加超时控制:5秒内未完成则取消并触发异常
        CompletableFuture<List<Map<String, Object>>> safeFuture =
            future.orTimeout(5, TimeUnit.SECONDS);

        // 处理异常:记录日志并返回空列表作为降级策略
        safeFuture.exceptionally(ex -> {
            System.err.println("Query failed or timed out: " + ex.getMessage());
            return List.of(); // 返回空列表
        }).thenAccept(results -> {
            System.out.println("Processed " + results.size() + " users.");
        });
    }
}
在 processWithSafety 方法中,我们首先对原始 Future 应用了 orTimeout(5, TimeUnit.SECONDS)。如果查询超过 5 秒,它将抛出 TimeoutException。紧接着,exceptionally() 块捕获该异常,打印错误信息并返回一个空的 List,从而保证下游的 thenAccept 依然能正常执行,只是处理的是空数据。这种组合模式确保了系统的鲁棒性,避免了因单个 DB 查询失败导致整个服务雪崩。


















