








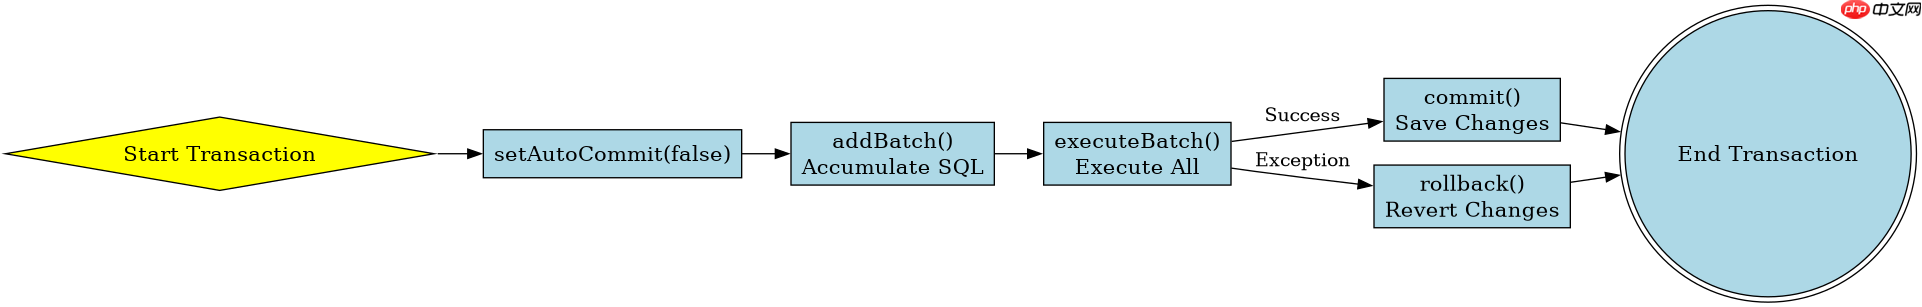
java jdbc 实现批量操作数据血缘,核心在于利用 connection 的 setautocommit(false) 开启事务,通过 addbatch() 累积 sql,并在 executebatch() 成功后调用 commit() 提交。在此过程中,需捕获 sqlexception 并执行 rollback() 以保障原子性,同时记录每条语句的执行状态用于血缘追踪。
JDBC 事务中如何确保批量操作的原子性
在 JDBC 中,确保批量操作原子性的标准做法是手动管理事务边界。默认情况下,JDBC 连接处于自动提交模式,每条 SQL 都会立即生效。要将其改为事务模式,必须显式调用 connection.setAutoCommit(false)。随后,将一系列更新操作添加到批处理队列中,最后统一执行并提交。如果任何一步失败,则回滚所有更改。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.SQLException;

public class BatchTransactionExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 关闭自动提交,开启事务
            conn.setAutoCommit(false);

            String sql = "INSERT INTO logs (action, timestamp) VALUES (?, ?)";
            try (var ps = conn.prepareStatement(sql)) {
                // 2. 添加批量操作
                for (int i = 0; i < 100; i++) {
                    ps.setString(1, "ACTION_" + i);
                    ps.setLong(2, System.currentTimeMillis());
                    ps.addBatch();
                }

                // 3. 执行批量操作
                int[] results = ps.executeBatch();

                // 4. 提交事务
                conn.commit();
                System.out.println("Batch executed successfully. Results: " + results.length);
            } catch (SQLException e) {
                // 5. 发生异常,回滚事务
                conn.rollback();
                throw e;
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
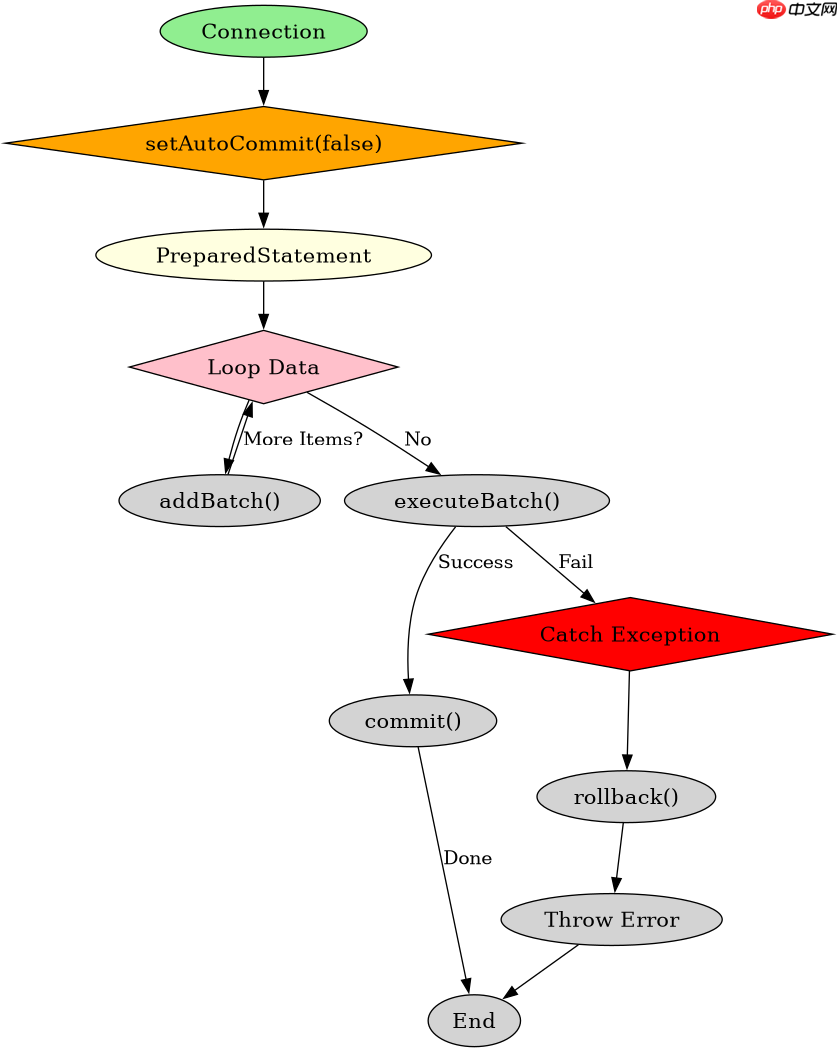
上述代码展示了标准的 JDBC 事务流程。首先获取连接并禁用自动提交。接着使用预编译语句 PreparedStatement 循环添加参数到批次。调用 executeBatch() 后,数据库会尝试执行所有语句。若成功,调用 commit() 使变更永久化;若抛出异常,进入 catch 块调用 rollback() 撤销已执行的语句,确保数据一致性。
立即学习“Java免费学习笔记(深入)”;

如何在批量操作中集成数据血缘记录
要在批量操作中集成数据血缘,需要在执行前后记录数据的来源、去向及转换逻辑。这通常涉及在事务内插入额外的元数据表记录,或者在应用层构建血缘图谱对象。关键是在 executeBatch() 返回结果后,解析执行影响行数,并将这些操作映射到具体的业务实体上。

import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;
import java.util.ArrayList;
import java.util.List;

public class BloodlineBatchProcessor {

    private Connection conn;
    private List<String> bloodlineRecords = new ArrayList<>();

    public BloodlineBatchProcessor(Connection conn) {
        this.conn = conn;
    }

    public void processWithBloodline(List<String> dataItems) throws SQLException {
        conn.setAutoCommit(false);
        String insertSql = "INSERT INTO target_table (data) VALUES (?)";
        String logSql = "INSERT INTO bloodline_log (source_data, operation, status) VALUES (?, ?, ?)";

        try (var targetPs = conn.prepareStatement(insertSql);
             var logPs = conn.prepareStatement(logSql)) {

            for (String item : dataItems) {
                // 执行主业务逻辑
                targetPs.setString(1, item);
                targetPs.addBatch();

                // 记录血缘信息
                logPs.setString(1, item);
                logPs.setString(2, "INSERT");
                logPs.setString(3, "PENDING");
                logPs.addBatch();
            }

            targetPs.executeBatch();
            logPs.executeBatch();

            // 更新血缘状态为成功
            updateBloodlineStatus(conn, "SUCCESS");
            conn.commit();
        } catch (SQLException e) {
            updateBloodlineStatus(conn, "FAILED");
            conn.rollback();
            throw e;
        }
    }

    private void updateBloodlineStatus(Connection conn, String status) throws SQLException {
        String sql = "UPDATE bloodline_log SET status = ? WHERE status = 'PENDING'";
        try (var ps = conn.prepareStatement(sql)) {
            ps.setString(1, status);
            ps.executeUpdate();
        }
    }
}
该示例展示了如何在同一事务中并行处理业务数据和血缘日志。通过维护一个 PENDING 状态的血缘记录,在批量操作成功后统一更新为 SUCCESS,失败时更新为 FAILED 并回滚。这种方式保证了血缘信息与业务数据的状态同步,且都在同一个事务边界内,避免了因部分成功导致的数据与血缘不一致问题。
当批量操作包含混合类型SQL时如何处理事务回滚
当批量操作中混合了 DML(如 INSERT/UPDATE)和 DDL(如 CREATE TABLE)或存储过程调用时,JDBC 的行为可能因数据库驱动而异。大多数关系型数据库不支持在单个 executeBatch() 中混合执行 DDL 和 DML,或者 DDL 会隐式提交事务。因此,处理此类混合操作时,应分批次执行,或在事务外单独处理 DDL,仅对 DML 部分使用事务控制。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.SQLException;

public class MixedOperationHandler {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // DDL 操作通常在独立事务或自动提交下执行
            executeDdl(conn);

            // DML 批量操作使用显式事务
            executeDmlBatch(conn);
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }

    private static void executeDdl(Connection conn) throws SQLException {
        // DDL 隐式提交,不建议放在手动事务中
        try (var stmt = conn.createStatement()) {
            stmt.execute("CREATE TEMPORARY TABLE IF NOT EXISTS temp_logs (id INT)");
        }
    }

    private static void executeDmlBatch(Connection conn) throws SQLException {
        conn.setAutoCommit(false);
        try (var ps = conn.prepareStatement("INSERT INTO logs (msg) VALUES (?)")) {
            for (int i = 0; i < 10; i++) {
                ps.setString(1, "Log " + i);
                ps.addBatch();
            }
            ps.executeBatch();
            conn.commit();
        } catch (SQLException e) {
            conn.rollback();
            throw e;
        }
    }
}
在实际开发中,应避免在同一个 executeBatch() 中混用 DDL 和 DML。最佳实践是将 DDL 操作分离出来,因为它通常会触发隐式提交,破坏当前事务的完整性。对于 DML 部分,继续使用标准的事务管理模式。这样既满足了结构变更的需求,又保证了数据操作的可回滚性。


















