





在 linux 服务器上规划 cpu 和内存,核心在于理解业务类型对资源的消耗模式。不同的应用场景(如 web 服务、数据库、大数据处理)对硬件的需求截然不同。盲目堆砌配置不仅浪费成本,还可能导致资源闲置或瓶颈转移。
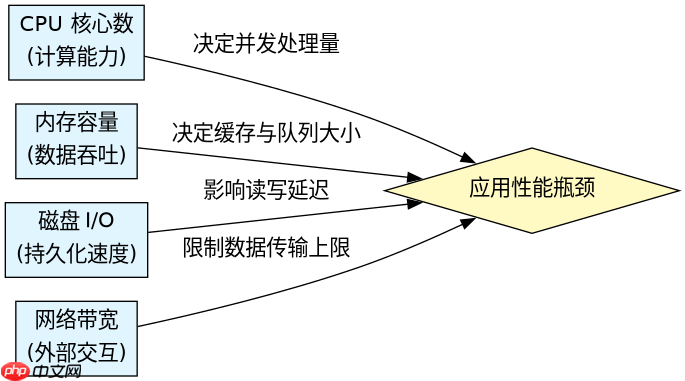
业务场景与资源映射
确定服务器用途是规划的第一步。通常我们将服务器分为几类:计算密集型、内存密集型和 I/O 密集型。
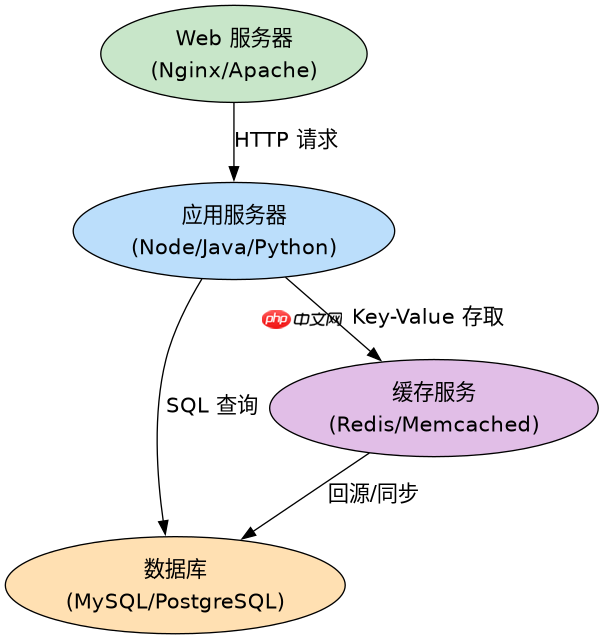
对于 Web 服务器(如 Nginx),主要瓶颈往往在网络连接数和上下文切换,CPU 需要足够的核心数以处理高并发请求,而内存主要用于缓冲静态文件。应用服务器(如 Java/Node.js)则高度依赖内存,因为 JVM 或 V8 引擎会占用大量堆空间,此时应优先保证大内存。数据库服务器(如 MySQL)最敏感的是磁盘 I/O 和内存缓存,CPU 只需满足事务处理即可,过高的 CPU 频率对查询加速有限。缓存服务(如 Redis)则是典型的内存密集型,数据全在内存中,CPU 仅用于指令执行,因此单核高频和大容量内存是关键。

Linux 安全审计工具,检查 SSH 配置、开放/监听端口、防火墙规则(ufw/iptables/nftables)、失败登录尝试、sudoers 权限...
具体配置方案与监控脚本
基于上述分析,我们可以制定具体的配置比例。以下是一个通用的参考标准:
- Web/App 混合服务器:CPU:内存 = 1:2 或 1:4。例如 4 核 8G 或 4 核 16G。适合大多数中小型网站。
- 纯数据库服务器:CPU:内存 = 1:4 或 1:8。例如 4 核 32G。确保 InnoDB Buffer Pool 能容纳热点数据。
- 计算/编译服务器:CPU:内存 = 1:1 或 2:1。例如 8 核 8G。重点是多核并行能力。
为了验证当前配置是否合理,我们需要持续监控资源使用情况。下面提供一个简单的 Shell 脚本,用于定期采集 CPU 和内存的使用率,并输出到日志文件中。该脚本适用于 CentOS/RHEL 系统。
#!/bin/bash
# monitor_resources.sh
# 用法: ./monitor_resources.sh /var/log/resource_monitor.log

LOG_FILE=$1
if [ -z "$LOG_FILE" ]; then
    echo "Usage: $0 <log_file_path>"
    exit 1
fi

while true; do
    TIMESTAMP=$(date '+%Y-%m-%d %H:%M:%S')

    # 获取 CPU 使用率 (取 idle 值的补数)
    CPU_IDLE=$(top -bn1 | grep "Cpu(s)" | awk '{print $8}')
    CPU_USAGE=$(echo "100 - $CPU_IDLE" | bc)

    # 获取内存使用率
    MEM_TOTAL=$(free -m | awk '/^Mem:/ {print $2}')
    MEM_USED=$(free -m | awk '/^Mem:/ {print $3}')
    MEM_USAGE=$(echo "scale=2; $MEM_USED * 100 / $MEM_TOTAL" | bc)

    echo "$TIMESTAMP | CPU: ${CPU_USAGE}% | MEM: ${MEM_USAGE}%" >> $LOG_FILE

    sleep 60
done
运行方法:赋予执行权限后,后台运行脚本并将结果追加到指定日志文件。预期结果是每 60 秒记录一次当前的 CPU 和内存负载。通过分析日志中的峰值,可以判断是否需要调整配置。如果 CPU 长期低于 20%,可能意味着 CPU 过剩;如果内存经常触发 Swap,则必须增加内存。
针对高并发场景的调优建议
当业务进入高并发阶段,单纯增加硬件可能无法解决问题,需要结合内核参数调优。例如,在高并发 TCP 连接场景下,默认的 `net.ipv4.tcp_tw_reuse` 和 `net.core.somaxconn` 设置可能成为瓶颈。通过修改 `/etc/sysctl.conf`,增加最大文件描述符数量(`fs.file-max`)和调整 TCP 时间等待状态复用,可以有效提升服务器的连接处理能力。同时,对于 Java 应用,需根据实际堆内存大小调整 `-Xms` 和 `-Xmx`,避免频繁 GC 导致 CPU 飙升。这些软件层面的优化,往往比硬件升级更具性价比。



















